Monitoring vs Observabilidad: el mismo incidente de las 3 AM, dos caminos
Monitoring te dice que algo anda mal. La observabilidad te dice qué salto de qué request se rompió, y por qué. Una comparación de system design con números, modos de falla y un caso real de streaming.
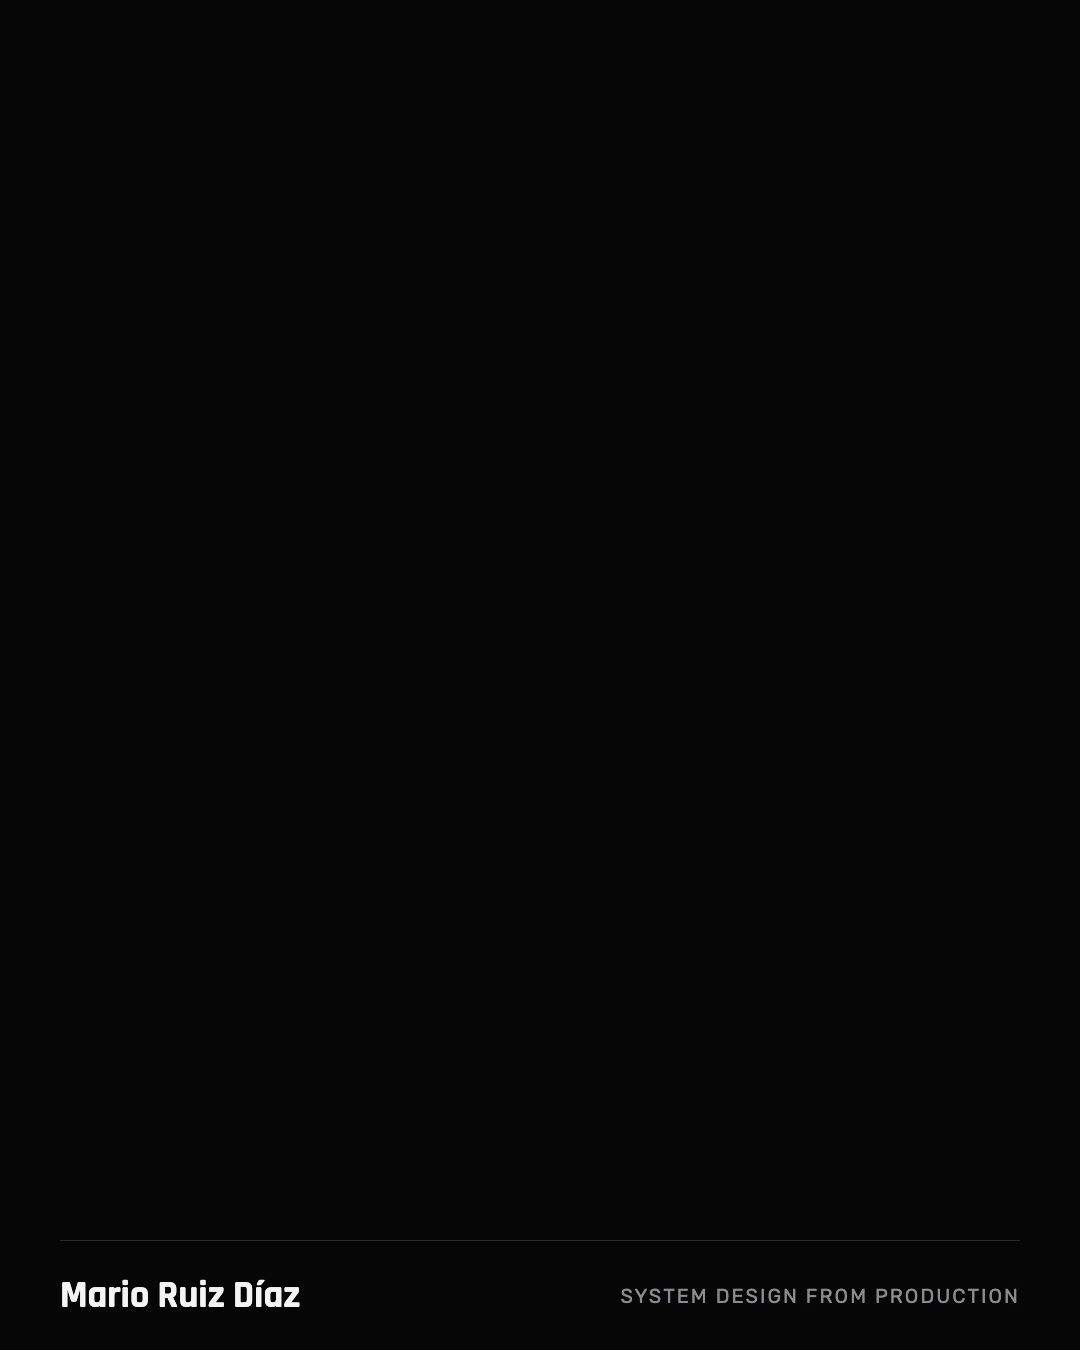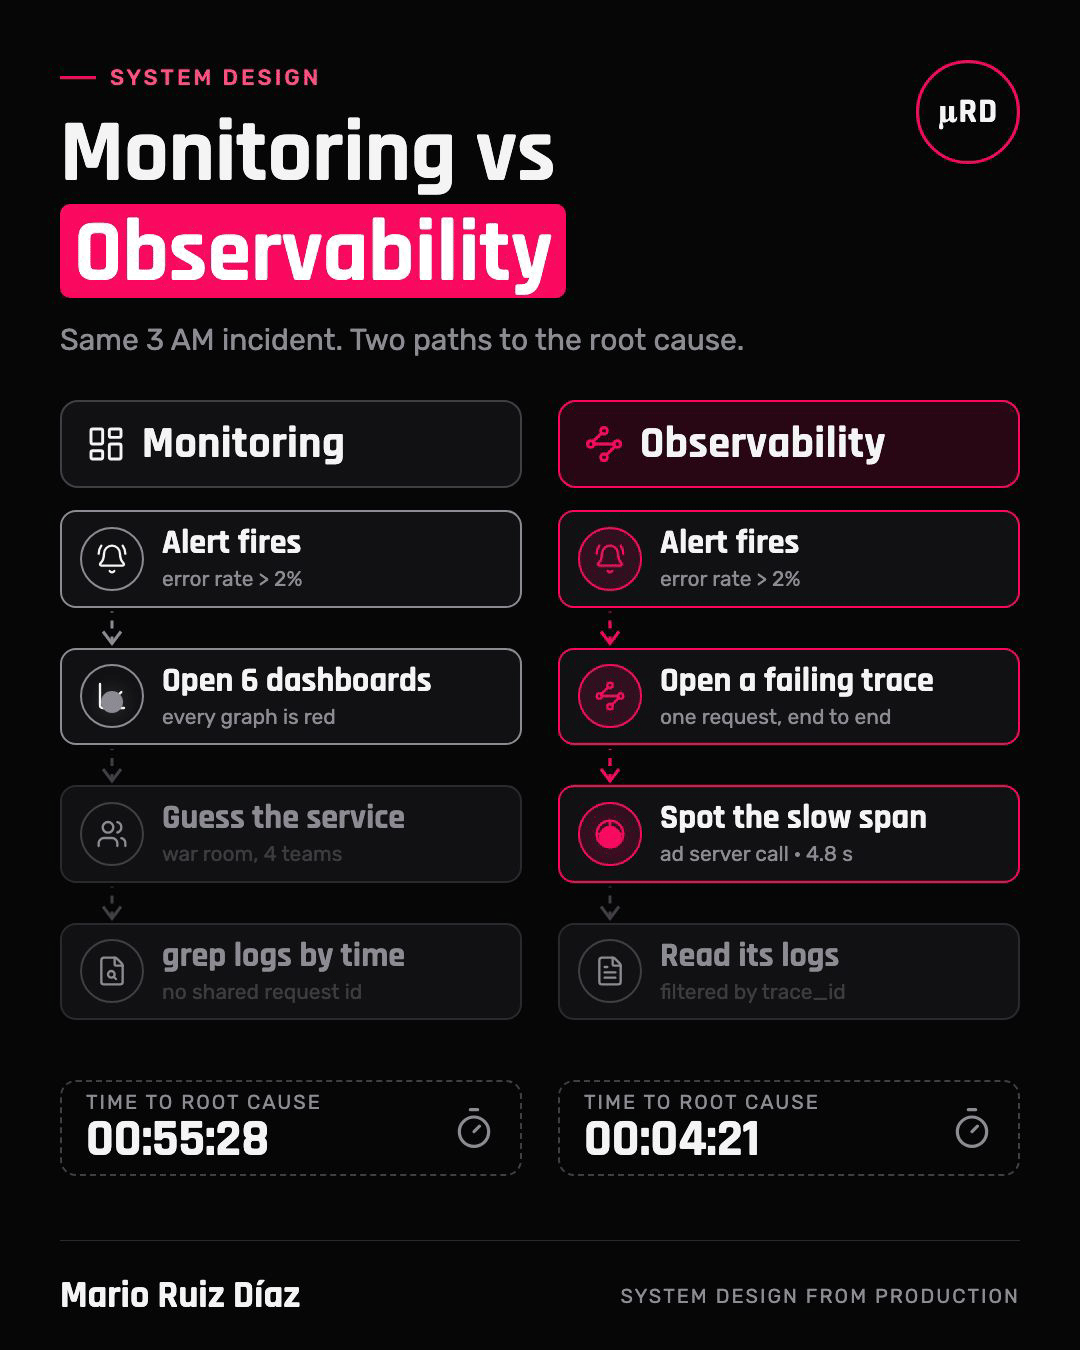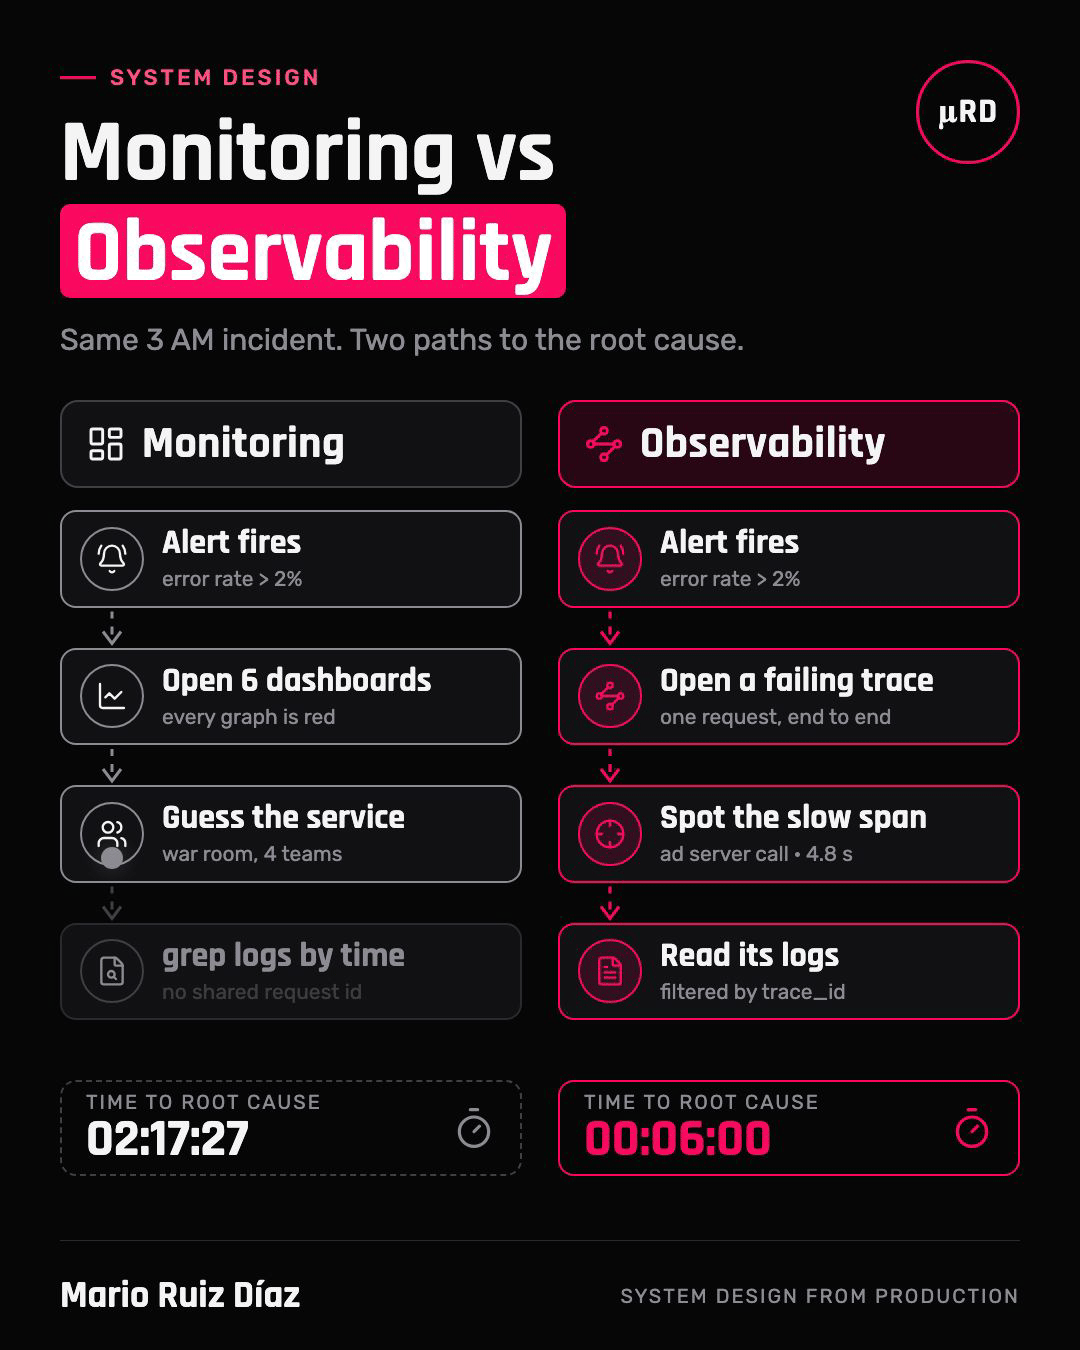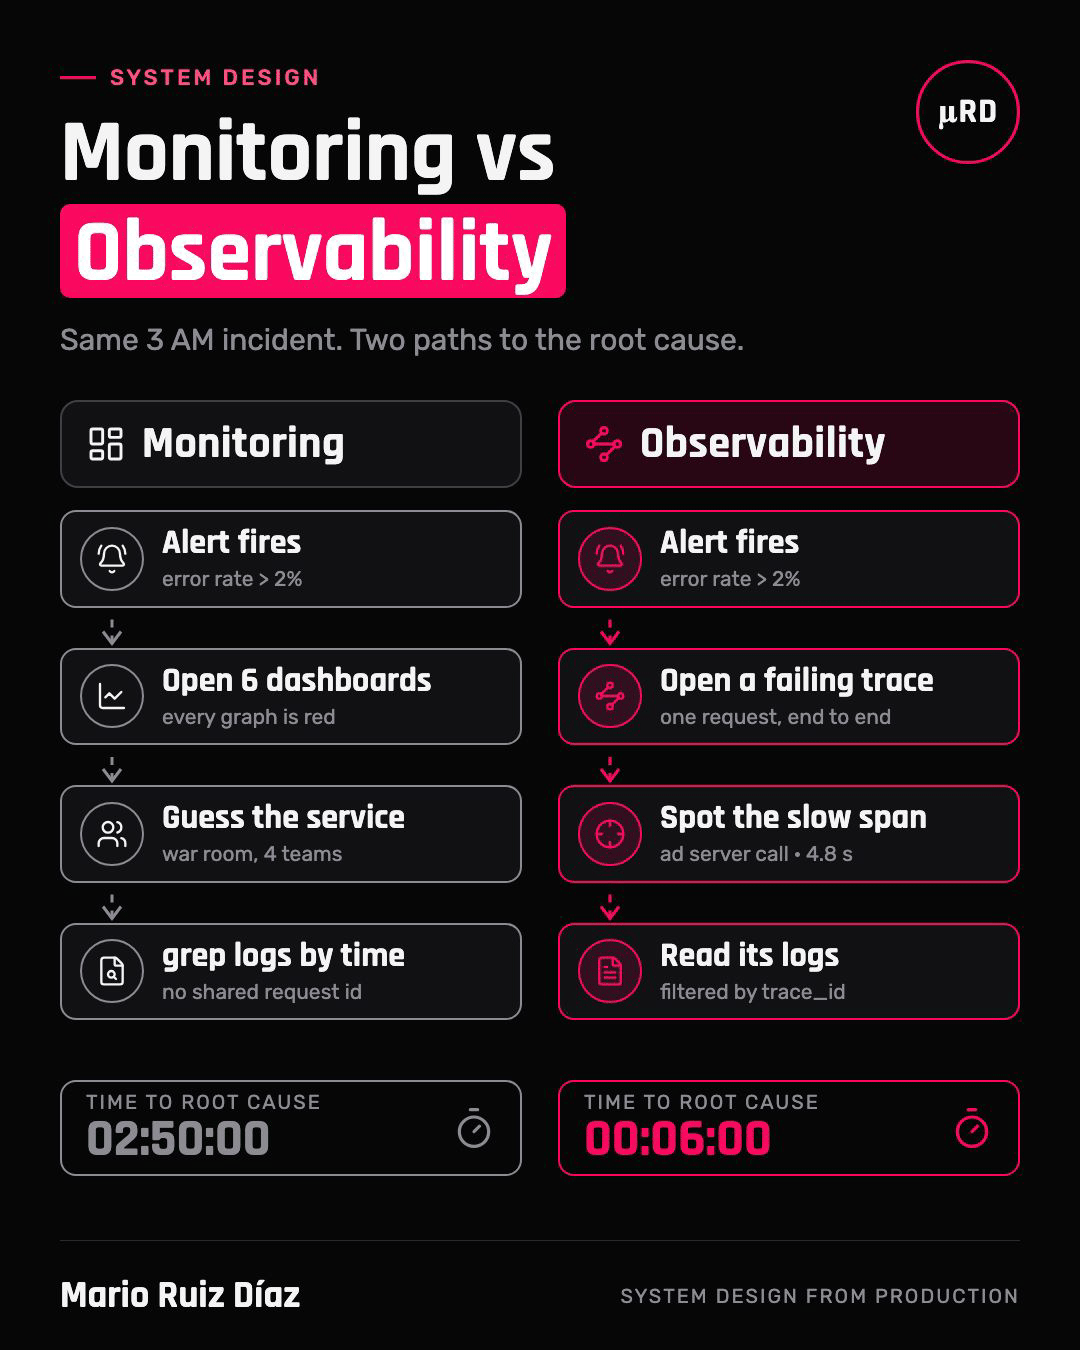
Son las 3:07 AM. Salta una alerta: el error rate de la API de anuncios pasó el 2%. Dos ingenieros de guardia, dos empresas, el mismo incidente.
El primero abre seis dashboards. Todos los gráficos están en rojo, porque todos los servicios que dependen del que falló también fallan. Se arma un war room con cuatro equipos, cada uno demostrando que su servicio es una víctima y no la causa. Alguien hace grep de logs por timestamp en tres stores distintos. La causa raíz aparece unas horas después.
El segundo hace click en un request que falló, abre su traza, ve un span de 4,8 segundos en una llamada a un ad server externo y salta a los logs de ese span exacto. La causa raíz aparece en minutos.
Misma arquitectura. Misma gente. La diferencia no es el presupuesto en herramientas: es si el sistema fue diseñado para explicarse a sí mismo. Este artículo compara las tres formas en que los equipos suelen llegar ahí, cuánto cuesta cada una y dónde se rompe cada una.
El problema: los síntomas viajan, las causas se esconden
En un monolito, una falla es ruidosa y está cerca de su causa: un proceso, un stack trace, un archivo de log. En un sistema distribuido, un solo request cruza muchos servicios, colas y proveedores. Una falla en el salto 3 aparece como errores en los saltos 4, 5 y 6, y como latencia en el borde.
Eso cambia la pregunta que tiene que responder la guardia. "¿Algo anda mal?" es fácil: ya lo dijo la alerta. Las preguntas difíciles son:
- Dónde se degradó este request: qué servicio, qué salto, qué dependencia.
- Por qué: qué tenían de distinto los requests que fallan (tenant, dispositivo, partner, payload, versión).
- Qué cambió primero: un deploy, un flag de configuración, un proveedor, la forma del tráfico.
Monitoring está hecho para preguntas que sabías hacer de antemano: CPU arriba de 80%, error rate arriba de 2%, profundidad de cola arriba de 10k. Observabilidad es la propiedad de un sistema que te deja hacerle preguntas nuevas en producción, sin deployar código nuevo. Monitoring es una funcionalidad que agregás; la observabilidad es una propiedad que diseñás.
Requisitos
Una vara útil para diseñar la respuesta a incidentes:
- Detectar una degradación visible para el usuario en menos de un minuto (sigue siendo trabajo de monitoring).
- Localizar el salto que falla para cualquier request individual, incluidos los saltos asíncronos por colas y terceros.
- Explicar la falla con contexto de negocio: qué tenant, partner, dispositivo o endpoint está afectado.
- Correlacionar las tres señales: de un pico en una métrica a trazas de ejemplo, de una traza a sus logs.
- Mantener el costo: el costo de telemetría tiene que crecer más lento que el tráfico.
Estimación de escala
Los números vuelven concretos los trade-offs. Tomemos un backend de streaming mediano (ilustrativo, no una empresa en particular):
| Dato | Valor |
|---|---|
| Requests pico en el borde | 3.000 req/s |
| Servicios que toca cada request | 8 (algunos vía colas) |
| Spans por request | ~12 |
| Tamaño promedio de un span | ~1 KB |
| Líneas de log por salto | ~5, ~300 bytes cada una |
Eso da:
- Spans: 3.000 × 12 = 36.000 spans/s → ~36 MB/s → ~3 TB/día si guardás todo.
- Logs: 3.000 × 8 × 5 = 120.000 líneas/s → ~36 MB/s → otros ~3 TB/día.
- Cardinalidad de métricas: etiquetá un contador de requests por dispositivo (50) × partner (200) × endpoint (30) × status (5) y obtenés 1,5 millones de series para una sola métrica. La mayoría de los backends de métricas cobran por serie; ahí mueren los presupuestos.
De la aritmética salen tres consecuencias de diseño:
- El contexto de alta cardinalidad va en spans y logs, no en métricas. Las métricas quedan con baja cardinalidad (servicio, endpoint, status); partner y dispositivo viven como tags de span que filtrás cuando hace falta.
- No podés guardar todas las trazas. Necesitás una estrategia de sampling que guarde las interesantes (errores, requests lentos) al 100% y una base chica del resto.
- Los logs tienen que dejar de duplicar contexto. Si el query string, el tenant y el dispositivo se escriben una vez en el span raíz, cada línea de log deja de repetirlos.
Enfoque 1: Monitoring (métricas, umbrales, dashboards)
Deslizá hacia el costado para ver el diagrama completo →
Cada servicio emite métricas agregadas (RED: rate, errors, duration; USE para recursos). Un motor de alertas evalúa umbrales y llama a alguien. Los dashboards muestran tendencias. Los logs existen, pero viven en stores separados y se buscan por timestamp y nombre de servicio.
Dónde brilla
- Barato y rápido. Los agregados comprimen millones de requests en unos pocos números por minuto.
- Excelente para detectar y para SLOs: las alertas por burn rate del error budget siguen siendo la mejor forma de despertar a alguien por las razones correctas.
- Fácil de adoptar: todo equipo entiende un dashboard.
Dónde se rompe
- Los agregados borran el request individual. Un gráfico de latencia p99 te dice que el 1% de los requests es lento; no te dice cuáles ni qué tienen en común.
- Las fallas en cascada pintan todo de rojo. Las víctimas aguas abajo y la causa aguas arriba se ven iguales.
- La correlación es manual. Cruzar un pico de una métrica con líneas de log por timestamp entre servicios, con relojes desfasados, es adivinar bajo presión.
Enfoque 2: Logs correlacionados
Deslizá hacia el costado para ver el diagrama completo →
El punto intermedio al que la mayoría de los equipos llega primero. El borde asigna un correlation ID a cada request; cada servicio lo loguea en JSON estructurado y lo reenvía en headers. Ahora podés consultar un ID y obtener cada línea que produjo ese request.
Dónde brilla
- Barrera baja: un middleware y una convención de logging.
- Un salto enorme frente al grep por timestamp. Un ID devuelve toda la historia, si todos lo loguearon.
Dónde se rompe
- Sin causalidad y sin tiempos. Obtenés una pila de líneas, no un árbol. ¿Qué llamada fue la padre? ¿Dónde se fueron los 4,8 segundos? Lo reconstruís leyendo.
- Los huecos son silenciosos. Un servicio que se olvida de reenviar el ID, un consumidor de cola que lo pierde, y el rastro se corta sin ningún error.
- El costo escala con la verbosidad. Para que los logs expliquen latencia, los equipos loguean más, y el volumen de logs ya es la línea más grande de la factura de telemetría.
Enfoque 3: Tracing distribuido con propagación de contexto
Deslizá hacia el costado para ver el diagrama completo →
Cada request lleva un contexto de traza (el header W3C traceparent: trace id, span id padre, flag de sampling). Cada servicio crea spans: operaciones medidas en el tiempo, con un padre, tags y estado. Los spans se exportan a un collector y se arman en un árbol: el request completo, salto por salto, con el tiempo de cada uno. Los logs se emiten con el trace_id y el span_id activos, así quedan adjuntos a la operación exacta que los produjo. Las métricas llevan exemplars: un link desde un pico a trazas de ejemplo.
Dónde brilla
- Localizar es visual. El span lento o con error aparece resaltado; no reconstruís nada.
- Contexto de negocio en los spans (partner, dispositivo, endpoint, status): cada traza se vuelve un evento consultable. "Todos los requests de anuncios que fallan para el partner X en dispositivos de TV desde el deploy de las 2:50."
- Las tres señales se unen por una clave. Métrica → traza de ejemplo → span → sus logs.
Dónde se rompe
- Huecos de propagación. El contexto viaja solo por HTTP con la instrumentación estándar. No cruza colas, jobs batch ni plataformas de terceros a menos que lo lleves explícitamente (ver modos de falla abajo).
- El sampling pierde la aguja. El sampling en la cabeza (decidir en el borde, por ejemplo guardar 10%) descarta el 90% de los errores raros que más necesitás.
- Deriva de instrumentación. Spans y tags son código; sin convenciones, cada equipo nombra las cosas distinto y las consultas entre servicios fallan.
- El costo, otra vez. Con ~3 TB/día de spans crudos, guardar todo rara vez se justifica.
Lado a lado
| Monitoring | Logs correlacionados | Tracing distribuido | |
|---|---|---|---|
| Responde | ¿Algo anda mal? | ¿Qué logueó este request? | ¿Dónde y por qué falló este request? |
| Unidad | Agregado por minuto | Línea de log | Árbol de spans por request |
| Saltos asíncronos | Invisibles | Solo si se reenvía el ID | Solo si se propaga el contexto |
| Tiempo por salto | No | Reconstruido a mano | Nativo |
| Cardinalidad | Tiene que ser baja | Alta, cara con volumen | Alta, en los spans |
| Costo principal | Cantidad de series | Volumen de logs | Volumen de spans (sampling) |
| Mejor para | Detectar, SLOs | Depurar un request conocido | Localizar, fallas desconocidas |
No son alternativas. Un sistema maduro usa métricas para detectar, trazas para localizar y logs para explicar, unidos por un trace id compartido. El trabajo de diseño está en las uniones.
Modos de falla de la observabilidad misma
Lo difícil no es agregar un SDK de tracing. Es todo lo que rompe la cadena en silencio.
Deslizá hacia el costado para ver el diagrama completo →
- Las colas pierden el contexto. Los headers HTTP no viajan dentro de un mensaje de SQS, SNS o Kafka. Inyectá el contexto de traza en los atributos o headers del mensaje al publicar y extraelo al consumir. Para consumidores batch que procesan 100 mensajes en una ejecución, un único padre es incorrecto: creá un span por mensaje o usá span links que apunten a cada productor.
- Las plataformas de terceros arrancan una traza nueva. Un proveedor que te llama de vuelta (un transcoder, un procesador de pagos, un ad server) no va a reenviar tus headers. Si su API acepta metadata, inyectá el contexto de traza en el payload y extraelo en el handler del callback. El paso externo aparece entonces dentro de la misma traza y no como una huérfana.
- El sampling en la cabeza descarta los errores. Decidí al final, no al principio: el tail-based sampling en el collector guarda el 100% de las trazas con error o por encima de un umbral de latencia, más un 1-5% del resto. Con los números de arriba, eso convierte ~3 TB/día en bastante menos de 200 GB sin perder ningún incidente.
- La cardinalidad de métricas explota. Un tag bien intencionado (user id, URL completa, partner × dispositivo) en una métrica multiplica las series. Imponé una lista permitida de tags de métricas y mandá todo lo demás a los spans.
- El desfase de relojes miente sobre la latencia. Spans de distintos hosts llevan relojes distintos. Confiá en las duraciones medidas dentro de un span; desconfiá de los huecos entre spans de hosts distintos.
- Datos sensibles en los tags. Los spans los consulta mucha gente. Redactá query strings y campos del payload en el SDK o en el collector, no en cada servicio.
Caso real: tracing del ad delivery en Pluto TV
Situación. Pluto TV es un servicio de streaming gratuito con publicidad: cada corte comercial es ingreso. Los servicios que deciden, buscan y preparan los anuncios corrían en AWS Lambda y contenedores, se comunicaban por HTTP, SQS y SNS, llamaban a ad servers VAST externos y le pasaban creatividades a Hybrik, una plataforma externa de transcoding. Cuando algo se rompía, la evidencia estaba repartida entre Loggly y CloudWatch, y los ingenieros reconstruían cada request a mano, servicio por servicio. Los saltos asíncronos rompían cualquier correlación simple.
Tarea. Hacer que un solo request de anuncios se pudiera inspeccionar de punta a punta, incluidos los saltos asíncronos y externos, y que eso fuera el estándar de los servicios de ingresos y no algo aislado.
Acción.
- Propuse y lideré una iniciativa de tracing distribuido con Datadog APM, y empecé con una prueba de concepto en el camino más difícil, no en el más fácil: tres servicios y una Lambda de estado de transcoding que ejercitaban todos los mecanismos de propagación a la vez.
- El contexto se propagó por HTTP (adProxy → adRequester), por atributos de mensajes SQS (adProxy → adCollector) y por notificaciones SNS.
- Hybrik no reenvía headers de traza, así que el contexto se inyectó en el payload del job enviado a Hybrik y se extrajo en la Lambda que manejaba su callback por SNS. El paso externo de transcoding quedó dentro de la misma traza.
- Los tags de negocio (app, dispositivo, partner, endpoint, status) fueron a los spans, así se volvieron filtros y métricas sin instrumentación extra. Los logs quedaron adjuntos a su span padre, y los campos pesados como los query strings se escribieron una sola vez en el span raíz en lugar de en cada línea de log.
- Cuando el camino más difícil funcionó, las mismas convenciones se extendieron a más de 20 servicios, y Datadog RUM en las apps mobile, web y TV conectó lo que vivían los espectadores con las trazas del backend.
Resultado. Un trace id contenía la historia completa de un request de anuncios, con los errores resaltados a nivel de traza. La investigación de incidentes pasó de reconstruir a mano, servicio por servicio, a un camino directo hacia el salto que fallaba, y las convenciones de tracing y tags se volvieron la base de los servicios de ingresos.
La lección que me quedo: probá la observabilidad en el camino donde la correlación es más difícil. Si funciona a través de una cola y de una plataforma de terceros, los servicios sincrónicos son fáciles.
Por dónde empezar
No hace falta reescribir la plataforma. En orden:
- Adoptá un estándar de contexto: W3C Trace Context vía OpenTelemetry, así todos los lenguajes y proveedores hablan el mismo header.
- Trazá primero el camino crítico para ingresos o clientes, de punta a punta, incluidas sus colas y proveedores.
- Cerrá los huecos asíncronos explícitamente: atributos de mensaje al publicar y consumir, inyección en el payload para terceros, span links para batches.
- Definí el contrato de tags: una lista corta de tags de negocio que lleva cada span, y una lista permitida para los tags de métricas.
- Hacé sampling en la cola: guardá cada error y cada traza lenta, y una base chica del resto.
- Uní las señales: trace id en cada línea de log, exemplars en las métricas de latencia.
- Revisá cada incidente con la traza abierta, y sumá la señal que te faltó.
La conclusión
Monitoring es cómo te enterás. Observabilidad es cómo encontrás dónde y por qué. Mantené monitoring para detectar y para los SLOs; diseñá para la observabilidad propagando el contexto por cada salto, poniendo contexto de negocio en los spans, haciendo sampling en la cola y uniendo métricas, trazas y logs por un mismo id. Cuando el sistema puede explicarse solo, un MTTR más bajo es una propiedad de la arquitectura y no el heroísmo de quien está de guardia.
Referencias
- W3C Trace Context, el estándar
traceparent/tracestate. - OpenTelemetry: señales y sampling.
- Libro de SRE de Google: Monitoring Distributed Systems.
- Charity Majors, Liz Fong-Jones, George Miranda, Observability Engineering (O'Reilly, 2022).