9 patrones de sistemas distribuidos y las fallas que previenen
Cada patrón de sistemas distribuidos existe porque algo se rompe: un nodo muere, una llamada no responde, un reintento cobra dos veces, un evento nunca llega. Nueve patrones, la falla que previene cada uno, la falla que introduce cada uno y cuándo no usarlo.
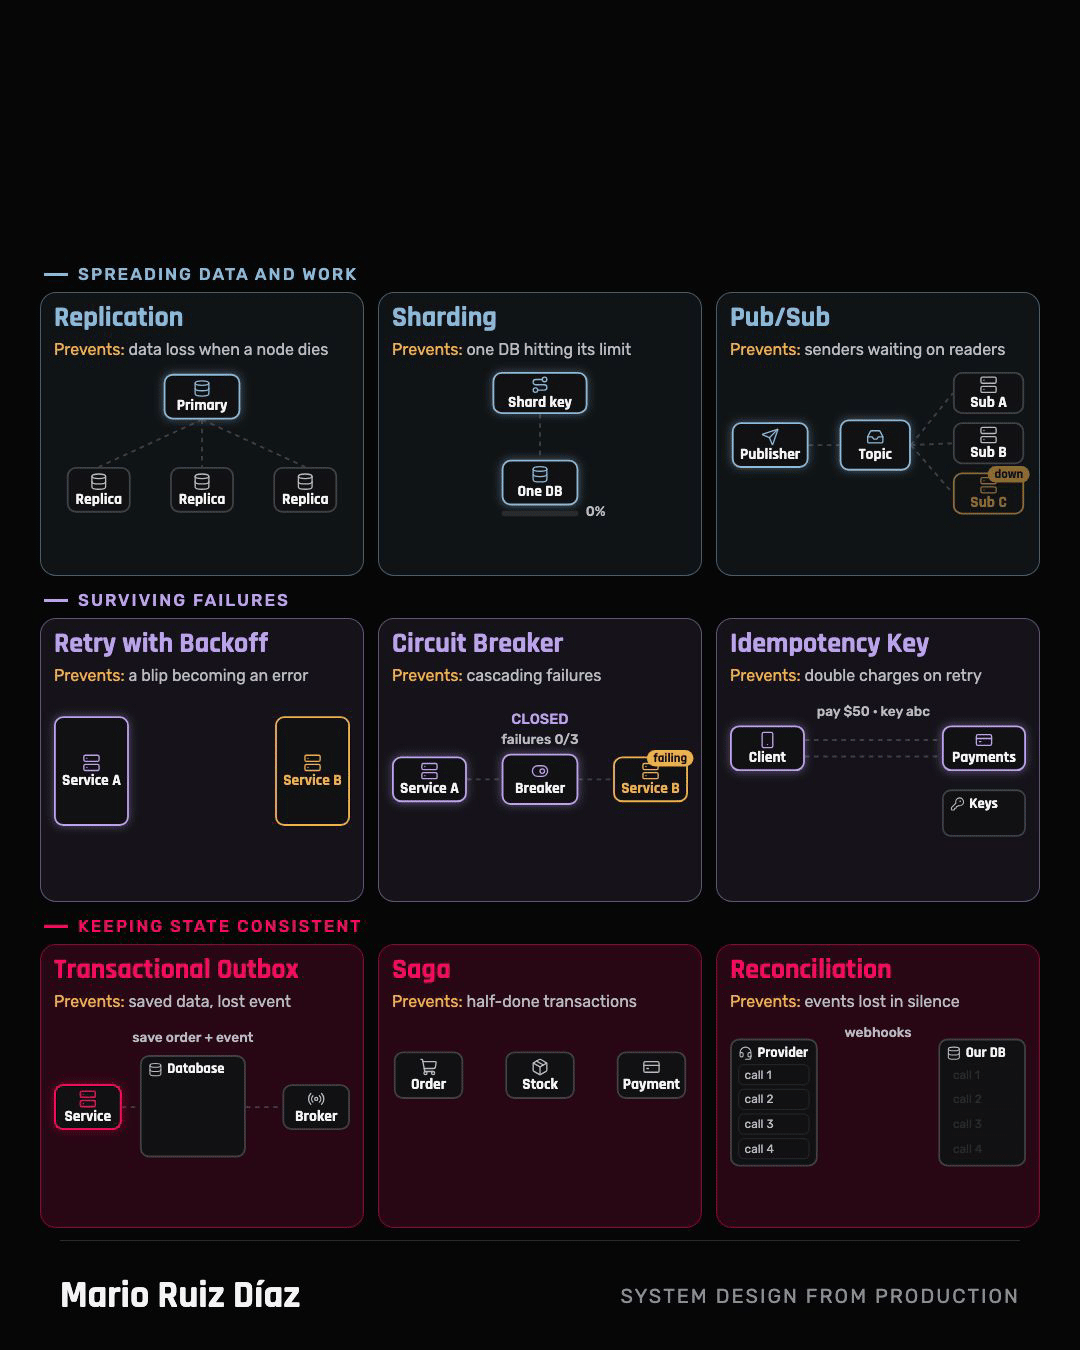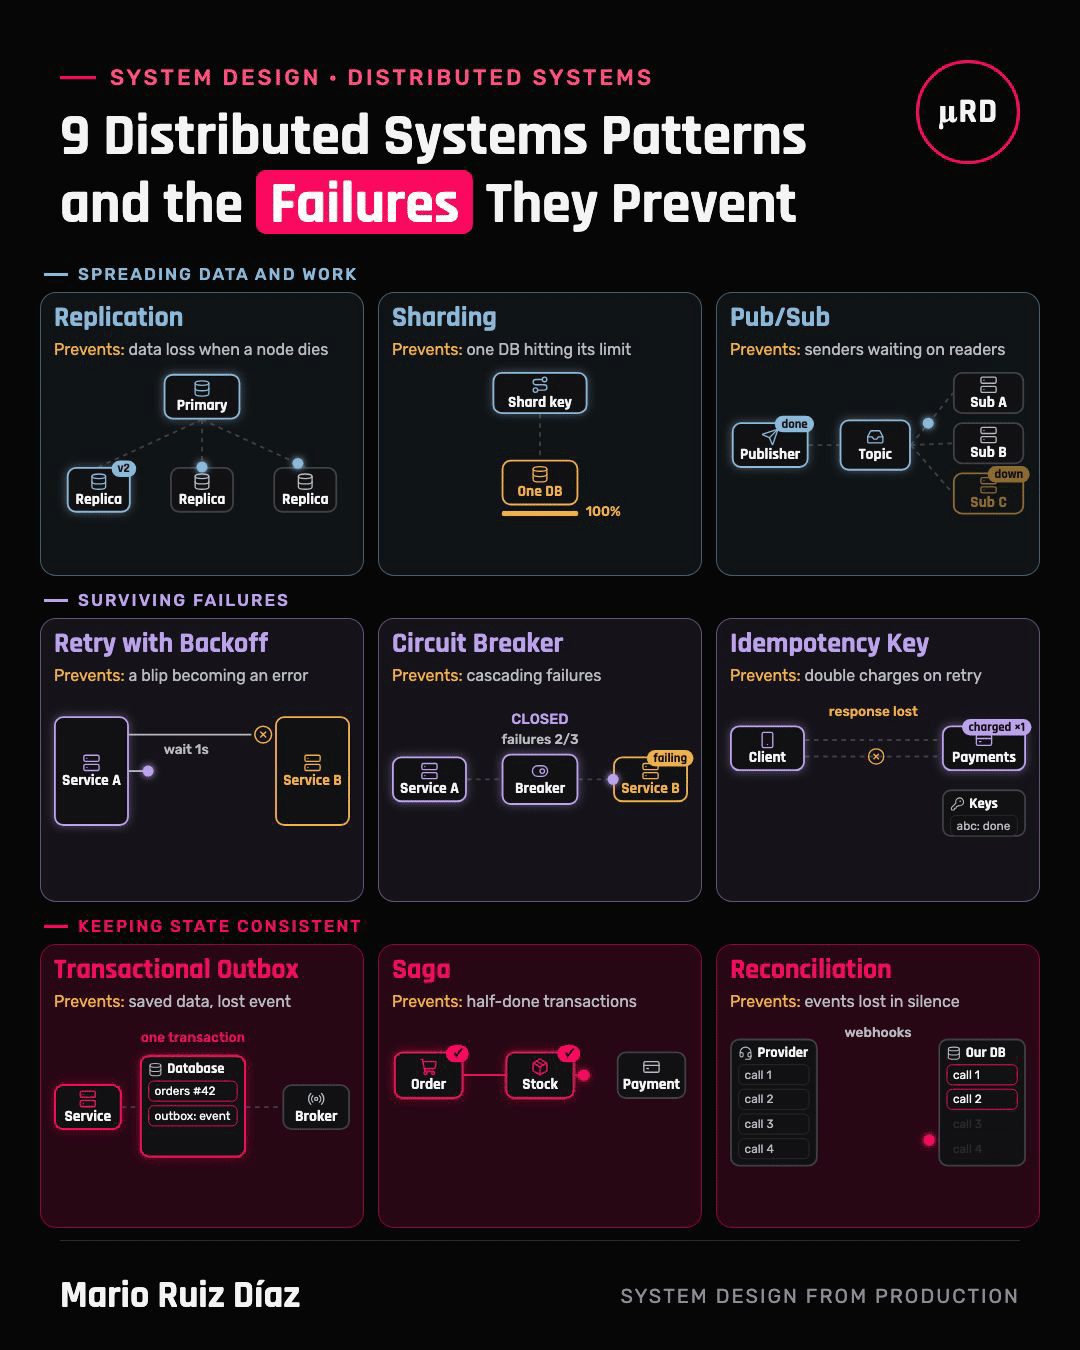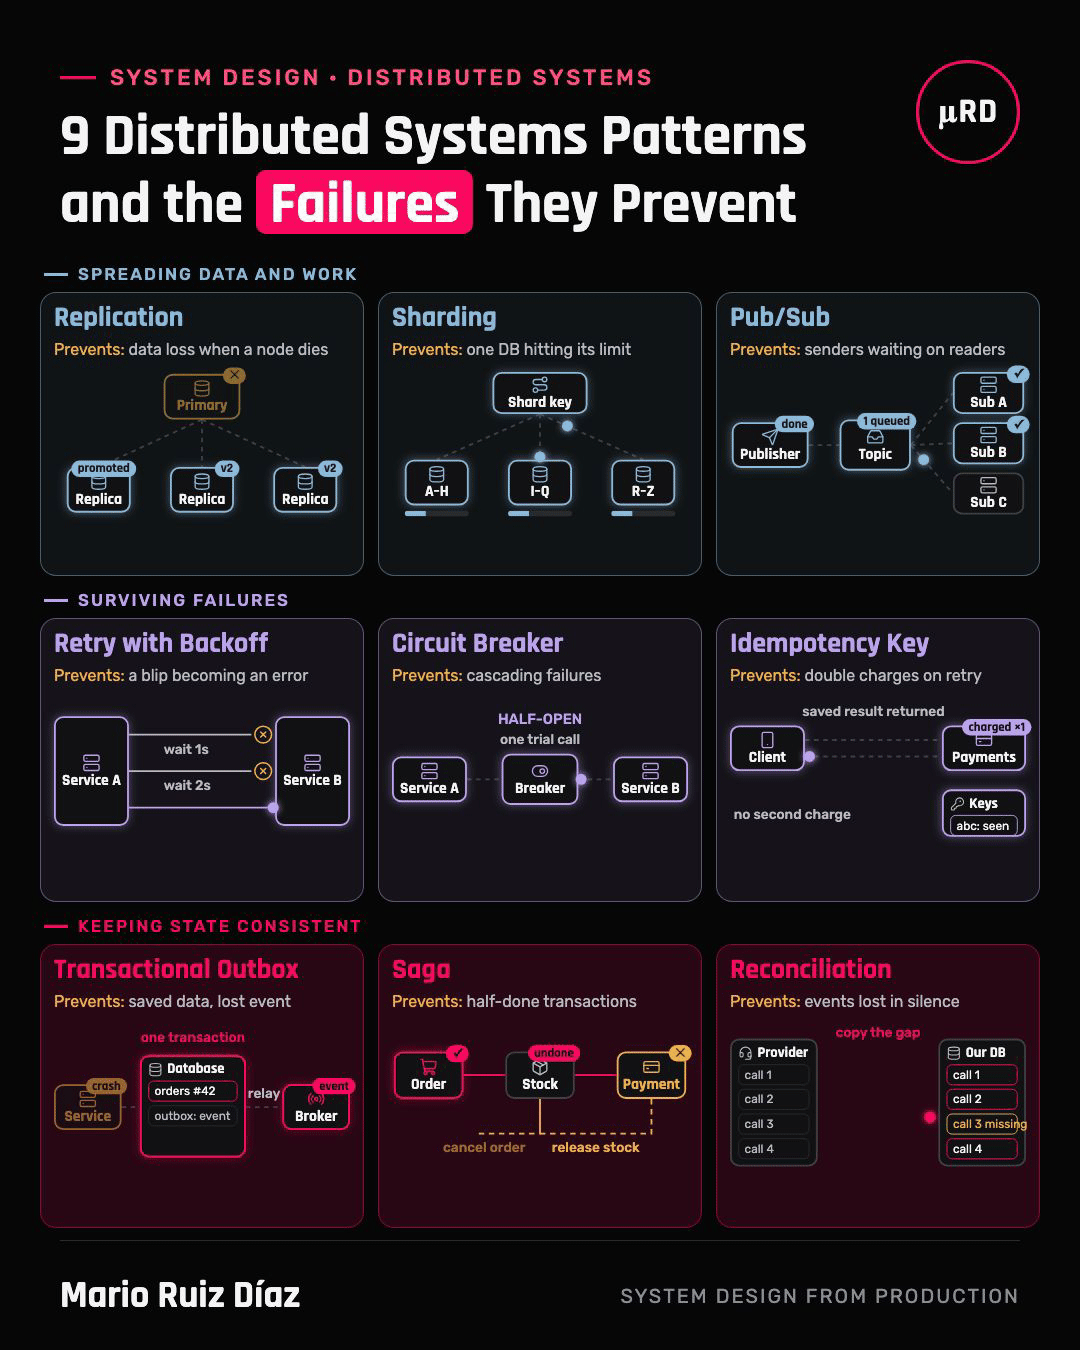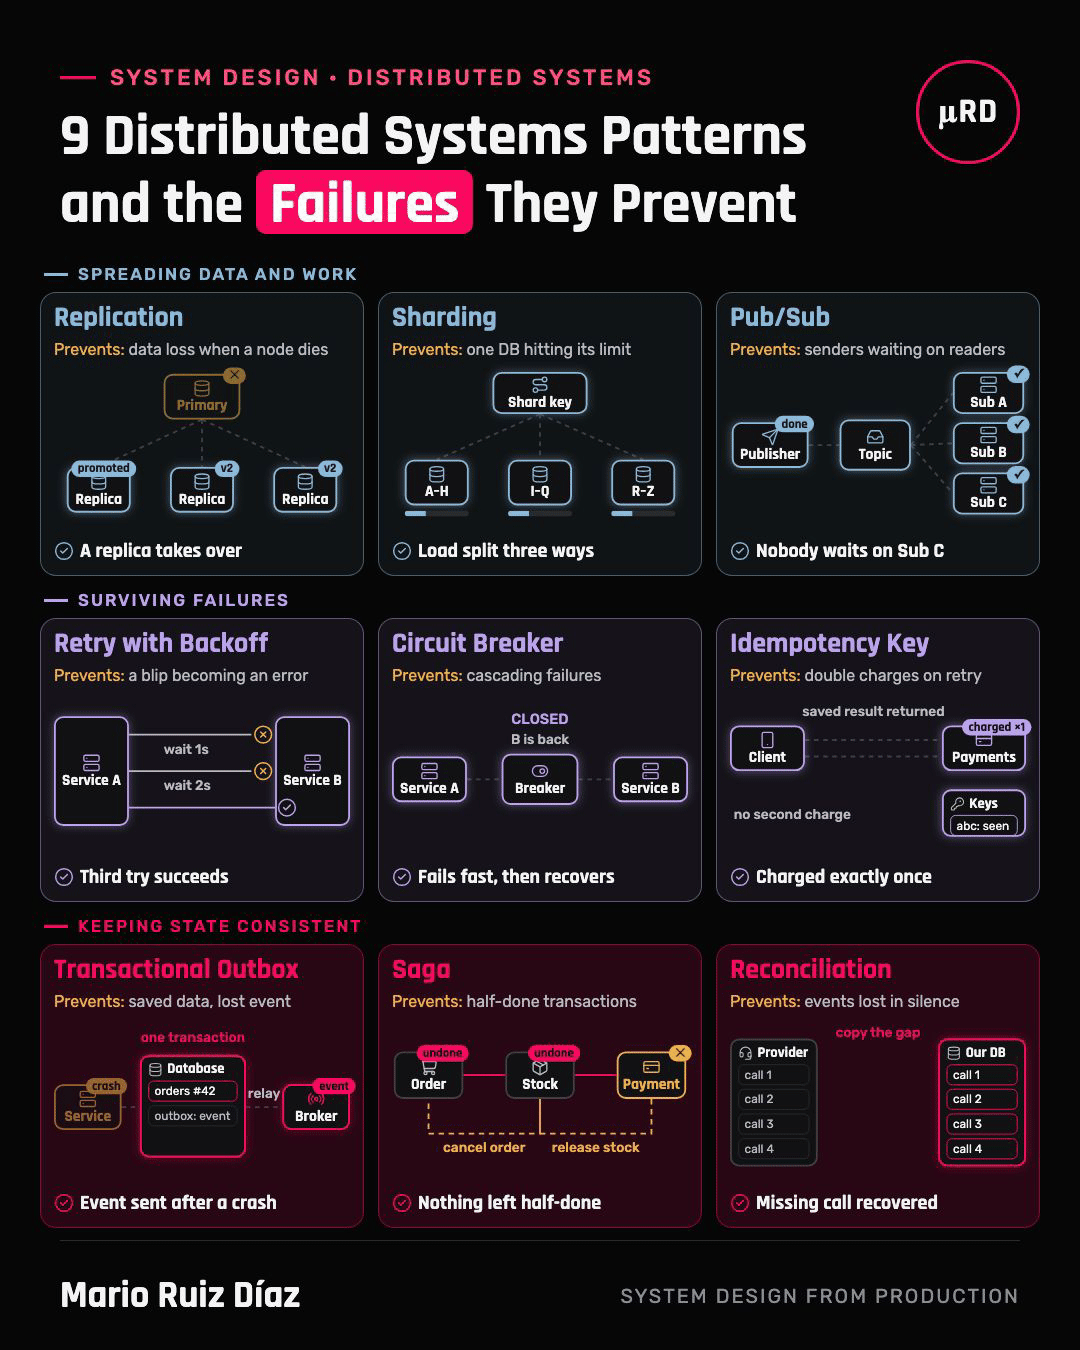
Las listas de patrones de sistemas distribuidos suelen definirlos: la replicación copia datos, el sharding los parte, un circuit breaker corta llamadas. Las definiciones son correctas y casi inútiles, porque se saltean la única pregunta que importa al diseñar: ¿qué se rompe si no hago esto, y qué se rompe porque lo hago?
Cada patrón de esta lista existe por una falla concreta. Y cada uno trae una falla propia, por eso ninguno es gratis y ninguno es un default. El artículo recorre nueve, agrupados por el problema que atacan: repartir datos y trabajo, sobrevivir a fallas y mantener el estado consistente. Para cada uno: la falla que previene, cómo funciona, cómo falla y cuándo no usarlo.
La lista deja afuera a propósito los internos del consenso, como la elección de líder y los quórums: la mayoría de los equipos los usa a través de etcd, ZooKeeper o su base de datos, no los construye. En su lugar incluye tres patrones que los equipos de aplicación implementan ellos mismos y que es fácil hacer mal: las claves de idempotencia, el transactional outbox y la reconciliación.
Repartir datos y trabajo
1. Replicación
Previene: perder datos, o el servicio entero, cuando muere una máquina.
Cómo funciona. Cada escritura va a un primario, que la copia a las réplicas. Las lecturas pueden ir a cualquier réplica. Si el primario muere, se promueve una réplica y el sistema sigue respondiendo.
Cómo falla. La copia es sincrónica (la escritura espera a las réplicas, así que es más lenta y se traba cuando una réplica está lenta) o asincrónica (rápida, pero las réplicas quedan atrasadas). Con replicación asincrónica, un failover puede perder las últimas escrituras que el primario viejo confirmó y nunca envió, y un cliente que lee de una réplica atrasada puede ver desaparecer su propia escritura. La promoción misma necesita una forma confiable de elegir exactamente un primario nuevo; por eso los gestores de failover se apoyan en un store de consenso (Patroni, para PostgreSQL, usa etcd, Consul o ZooKeeper), construido sobre algoritmos como Raft (paper de Raft).
No lo uses para escalar escrituras. Las réplicas multiplican la capacidad de lectura y la durabilidad; cada escritura sigue cayendo en un solo primario. Para escalar escrituras hace falta sharding.
2. Sharding
Previene: que una base de datos choque contra el límite de una sola máquina, en almacenamiento, escrituras o ambas.
Cómo funciona. Se parten los datos horizontalmente por una shard key: usuarios de la A a la H en una máquina, de la I a la Q en otra, de la R a la Z en una tercera. Una capa de ruteo manda cada pedido al shard dueño de su clave (Microsoft Azure Architecture Center).
Cómo falla.
- Claves calientes. Una mala clave concentra el tráfico: si partís por país, un país funde su shard mientras el resto está ocioso.
- Trabajo entre shards. Joins, agregaciones y transacciones que cruzan shards pasan a ser problema de la aplicación.
- Resharding. Agregar un shard implica mover datos. Con una ubicación ingenua
hash(key) % N, cambiar N mueve casi todas las claves; el consistent hashing limita el movimiento a cerca de 1/N de las claves (Karger et al., 1997; Amazon Dynamo).
No lo uses antes de necesitarlo. Una sola base bien indexada con réplicas llega muy lejos, y una shard key prematura es de las decisiones más difíciles de deshacer.
3. Pub/Sub
Previene: que quien envía tenga que esperar a cada receptor, o falle por culpa de alguno.
Cómo funciona. El publisher escribe un evento en un topic y sigue. Cada suscriptor lo lee a su ritmo. Un suscriptor caído se pone al día cuando vuelve; el publisher nunca se enteró de que no estaba (Microsoft Azure Architecture Center).
Cómo falla.
- Duplicados. La mayoría de los brokers entrega al menos una vez, así que cada consumidor tiene que ser idempotente (patrón 6).
- Eventos perdidos en el origen. Si el servicio escribe en su base y después publica, una caída en el medio pierde el evento (patrón 7).
- Orden. Suele estar garantizado solo por partición o por clave, no globalmente.
- Mensajes venenosos y atraso silencioso. Un mensaje que siempre falla hace girar en loop a un consumidor hasta que se lo aparta a una dead-letter queue, y el desacople esconde a un consumidor que se queda atrás, así que el lag de consumo tiene que ser una métrica monitoreada.
En producción. En Pluto TV, el sistema de control de frecuencia que diseñé está construido así: una API de beacons publica un evento NEW_IMPRESSION por cada anuncio visto en Kafka, y consumidores independientes mantienen el historial de impresiones, actualizan cuotas y limpian ventanas vencidas, cada uno escalando y fallando por su cuenta (el diseño completo).
No lo uses cuando quien llama necesita la respuesta para seguir. Un pedido que necesita respuesta es request/reply; forzarlo por un topic suma latencia y lógica de correlación a cambio de nada.
Sobrevivir a fallas
4. Retry con backoff
Previene: que un problema breve (una conexión que se cae, una llamada con throttling, un failover en curso) llegue al usuario como error.
Cómo funciona. Se reintenta la llamada fallida esperando cada vez más: 1 s, 2 s, 4 s, con jitter (una variación aleatoria) para que miles de clientes que fallaron juntos no reintenten juntos. Se corta después de unos pocos intentos (AWS Builders' Library).
Cómo falla.
- Tormentas de reintentos. Los reintentos multiplican la carga justo cuando una dependencia está en problemas, y se acumulan entre capas: tres capas que reintentan tres veces cada una convierten una falla en 27 llamadas.
- Efectos secundarios duplicados. Reintentar una llamada que ya había salido bien, pero cuya respuesta se perdió, la repite. Ese es el patrón 6.
- Mensajes que nunca llegan. Un reintento solo cubre las fallas que el sistema puede ver; un evento que nunca se entregó nunca se reintenta. Ese es el patrón 9.
Reintentá solo errores transitorios, solo operaciones idempotentes y dentro de un presupuesto de reintentos.
No lo uses para errores que no se van solos: un error de validación, un permiso faltante, un 404.
5. Circuit breaker
Deslizá hacia el costado para ver el diagrama completo →
Previene: la falla en cascada, donde quienes llaman acumulan threads y conexiones esperando a una dependencia que ya está caída, hasta que se caen ellos también.
Cómo funciona. Un breaker envuelve las llamadas a una dependencia y cuenta fallas. Cerrado: las llamadas pasan. Cuando las fallas superan un umbral, se abre: las llamadas fallan de inmediato, idealmente hacia un fallback, y la dependencia tiene margen para recuperarse. Después de una espera pasa a semiabierto y deja pasar una llamada de prueba; si sale bien, cierra; si falla, vuelve a abrir (Martin Fowler; popularizado por Release It! de Michael Nygard).
Cómo falla. Los umbrales son difíciles de ajustar: demasiado sensible y abre por ruido, demasiado laxo y abre cuando el daño ya está hecho. Necesita un fallback con sentido, o "fallar rápido" solo significa "fallar". Y un breaker por instancia ve solo su propio tráfico, así que distintas instancias pueden opinar distinto sobre la misma dependencia.
No lo uses para llamadas a recursos locales, dentro del proceso, o donde una falla tiene que verse de inmediato igual. Combinalo con timeouts: sin timeout, una dependencia lenta nunca cuenta como falla.
6. Clave de idempotencia
Deslizá hacia el costado para ver el diagrama completo →
Previene: que un pedido reintentado haga su trabajo dos veces: un cobro doble, un email duplicado, un evento contado dos veces.
Cómo funciona. El cliente genera una clave única por operación lógica y la manda en cada intento. El servidor guarda la clave junto con el resultado de la primera ejecución; un reintento con la misma clave recibe el resultado guardado en lugar de ejecutarse de nuevo (Stripe; draft de IETF del header Idempotency-Key). Para eventos, la misma idea es una clave de deduplicación: los consumidores registran los ids que ya procesaron.
Cómo falla.
- Intentos concurrentes. Dos intentos pueden llegar al mismo tiempo, así que la clave se tiene que reclamar de forma atómica (una restricción de unicidad, una escritura condicional), o corren los dos.
- Retención. Si las claves se guardan poco tiempo, un reintento tardío vuelve a ejecutarse; si se guardan para siempre, el store solo crece.
- Reuso de claves. Una clave enviada con un payload distinto se tiene que rechazar, no contestar con el resultado viejo.
No lo uses para operaciones naturalmente idempotentes, como asignar un valor o borrar por id: la operación ya da la garantía.
Mantener el estado consistente
7. Transactional outbox
Deslizá hacia el costado para ver el diagrama completo →
Previene: la doble escritura. La base confirma pero el evento nunca se publica, o el evento sale y la escritura falla, así que otros servicios actúan sobre un estado que no existe.
Cómo funciona. En la misma transacción local que cambia los datos de negocio, se inserta el evento en una tabla outbox: se confirman los dos o ninguno. Un relay separado lee la outbox y publica en el broker, ya sea consultando la tabla o siguiendo el log de cambios de la base con change data capture (microservices.io; outbox event router de Debezium).
Cómo falla. El relay entrega al menos una vez: si se cae después de publicar y antes de marcar la fila como enviada, el evento vuelve a salir, así que los consumidores necesitan idempotencia (patrón 6). El orden se mantiene solo si el relay lo preserva por entidad. Y la outbox necesita limpieza, o termina siendo la tabla más grande de la base.
No lo uses cuando nada aguas abajo depende de que el evento llegue, como una analítica best-effort.
8. Saga
Deslizá hacia el costado para ver el diagrama completo →
Previene: una operación de negocio que queda a medias entre servicios, como una orden creada y un stock reservado que nunca se cobraron.
Cómo funciona. La operación se parte en transacciones locales, una por servicio, cada una con una acción compensatoria que la deshace semánticamente. Si un paso falla, la saga ejecuta las compensaciones de los pasos ya completados, del más nuevo al más viejo (Garcia-Molina & Salem, 1987; microservices.io). Los pasos se coordinan con un orquestador o con servicios que reaccionan a los eventos de los otros (coreografía), y ahí entra la outbox.
Cómo falla. No hay aislamiento: otros pedidos ven los estados intermedios (stock reservado para una orden que se va a cancelar). Las compensaciones tienen que ser idempotentes y reintentables, porque también pueden fallar. Algunas acciones no se pueden deshacer, como un email ya enviado, y hay que dejarlas para el final o diseñarlas reversibles.
No lo uses cuando los datos entran en una sola base: una transacción ACID local es más simple y más fuerte.
9. Reconciliación
Previene: un estado que se desvía en silencio de la fuente de verdad porque se perdió un evento, nunca llegó un webhook o un bug salteó una escritura. Son las fallas que ningún reintento puede ver.
Cómo funciona. Periódicamente se compara la copia propia con la fuente de verdad y se repara la diferencia: se trae lo que tiene la fuente, se detecta lo que falta o está mal y se encola el arreglo. Dynamo aplica la misma idea entre réplicas, comparando árboles de Merkle en segundo plano (Amazon Dynamo), y los controladores de Kubernetes están construidos como loops que acercan el estado real al deseado (Kubernetes).
Cómo falla. Es tan bueno como la API de la fuente: los rate limits y la paginación limitan cada cuánto y hasta cuándo hacia atrás se puede comparar. La reparación tiene que ser idempotente, porque el evento que recupera puede llegar tarde igual. Y un hueco vive hasta la próxima corrida, así que el intervalo es una decisión de producto.
En producción. En Afterhour recupera las llamadas cuyo webhook nunca llegó (el caso real, más abajo).
No lo uses como sustituto de arreglar un camino de entrega que controlás. Es la red de seguridad para los que no controlás.
Lado a lado
| Patrón | Previene | Te cuesta | Herramientas comunes |
|---|---|---|---|
| Replicación | Pérdida de datos, caída al morir un nodo | Lag de réplicas, failover complejo | Replicación de PostgreSQL, MySQL, replica sets de MongoDB |
| Sharding | Los límites de una máquina | Claves calientes, queries entre shards, resharding | Vitess, Citus, MongoDB, particiones de DynamoDB |
| Pub/Sub | Emisores acoplados a receptores | Duplicados, orden, lag escondido | Kafka, SNS/SQS, Pub/Sub, NATS |
| Retry con backoff | Errores transitorios que llegan al usuario | Tormentas de reintentos, efectos duplicados | Políticas de retry de los SDKs, resilience4j, Polly |
| Circuit breaker | Falla en cascada | Ajuste, fallbacks, visión por instancia | resilience4j, outlier detection de Envoy, Polly |
| Clave de idempotencia | Efectos duplicados al reintentar | Un store de claves, reclamos atómicos, retención | Restricciones de unicidad, escrituras condicionales, Redis |
| Transactional outbox | Datos guardados con el evento perdido | Un relay, duplicados, limpieza de la tabla | Debezium, relays por polling |
| Saga | Operaciones a medias entre servicios | Sin aislamiento, lógica de compensación | Temporal, Step Functions, Camunda |
| Reconciliación | Desvío silencioso de la fuente de verdad | Demora hasta la próxima corrida, límites de la API | Jobs programados, controladores estilo Kubernetes |
Los patrones se encadenan
Estos nueve son más una cadena que una lista: cada uno cubre una falla que introducen los anteriores.
- El retry necesita una clave de idempotencia. Los reintentos absorben los problemas breves; las claves aseguran que reintentar algo que ya salió bien no lo haga dos veces.
- Pub/Sub necesita una outbox. Los topics desacoplan los servicios; la outbox asegura que el evento se publique si y solo si los datos se guardaron.
- Las sagas necesitan las dos. Cada paso es una transacción local que publica su evento por una outbox, y cada paso y cada compensación son idempotentes porque se van a reintentar.
- Todo necesita reconciliación. Los reintentos, las outbox y las sagas cubren las fallas que el sistema puede ver. Una comparación periódica contra la fuente de verdad atrapa el resto.
- Los circuit breakers mantienen honestos a los reintentos. Sin uno, cada capa sigue reintentando contra una dependencia que ya está caída.
Caso real: el pipeline de llamadas de Afterhour
Deslizá hacia el costado para ver el diagrama completo →
Situación. Afterhour es un recepcionista de voz con IA, multi-tenant, para estudios jurídicos, que construí para Big Voodoo Interactive. Para un estudio, una llamada perdida es un caso perdido, así que cada llamada que termina tiene que procesarse: extracción estructurada, archivo de la grabación, notificaciones y sincronización con el CRM. El proveedor de voz informa las llamadas terminadas con un webhook.
Tarea. Volver confiable el procesamiento posterior a la llamada cuando cualquier paso puede fallar y cuando ni siquiera está garantizado que llegue el webhook.
Acción.
- Primero persistir, después procesar. El handler del webhook (API Gateway + Lambda) solo guarda el payload crudo y encola el id de la llamada en SQS. El procesamiento puede fallar, reintentarse o reprocesarse sin perder nunca la llamada original.
- Jobs tipados con calendarios de reintento y dead-letter queues. Cada tipo de job declara su propio calendario de reintentos; un job que agota sus reintentos termina en una dead-letter queue en lugar de girar en loop o desaparecer.
- Reconciliación para lo que los reintentos no ven. Los reintentos solo cubren fallas que llegan al sistema. Cerca del 7% de las llamadas nunca llegaba por webhook, así que un job de EventBridge compara contra el proveedor cada 5 minutos y encola las que faltan.
- Observabilidad antes que funcionalidades. Métricas propias, dashboards y alertas hicieron visibles las fallas silenciosas, y así se encontró y midió el problema de las llamadas faltantes.
Resultado. Las llamadas perdidas por la entrega del webhook, cerca del 7%, ahora se recuperan solas, y la plataforma lleva procesadas más de 25.000 llamadas en producción.
La lección que me quedo: el retry con backoff te protege de las fallas que ves; la reconciliación encuentra las que no ves. Reintentos, una dead-letter queue y un loop de reconciliación son tres respuestas distintas para tres fallas distintas.
Leé el caso completo: Afterhour, un recepcionista de voz con IA que no pierde llamadas →
Por dónde empezar
- Nombrá primero la falla. Escribí qué se rompe y con qué frecuencia, antes de elegir un patrón.
- Preferí la opción aburrida. Una base con réplicas, llamadas sincrónicas con timeouts, una transacción local. Sumá un patrón cuando la falla que previene sea real.
- Hacé idempotentes las operaciones temprano. Los reintentos, pub/sub, las outbox y las sagas dependen de eso.
- Nunca escribas por separado en una base y en un broker. Usá una outbox, o hacé del broker la fuente de verdad.
- Sumá un loop de reconciliación por cada fuente externa de la que dependés: webhooks, APIs de terceros, eventos de otros equipos.
- Medí el modo de falla nuevo. Lag de réplicas, lag de consumidores, estado del breaker, backlog de la outbox, huecos reconciliados: cada patrón suma una métrica que ahora tenés que mirar.
La conclusión
Un patrón de sistemas distribuidos es un intercambio: elimina una falla y agrega otra. La replicación cambia pérdida de datos por lag, los reintentos cambian errores transitorios por duplicados, las claves de idempotencia cambian duplicados por un store de claves, las outbox cambian eventos perdidos por un relay, las sagas cambian operaciones a medias por lógica de compensación. Aprendé la falla que previene cada patrón y la que introduce, y vas a saber cuándo usarlo y cuándo no.
Referencias
- Karger et al., Consistent hashing and random trees (1997).
- DeCandia et al., Dynamo: Amazon's highly available key-value store (2007).
- Ongaro & Ousterhout, In search of an understandable consensus algorithm (Raft).
- AWS Builders' Library, Timeouts, retries and backoff with jitter.
- Martin Fowler, CircuitBreaker.
- Stripe, Designing robust and predictable APIs with idempotency, e IETF, The Idempotency-Key HTTP header field (draft).
- Chris Richardson, Transactional outbox y Saga; Debezium, Outbox event router.
- Garcia-Molina & Salem, Sagas (1987).
- Kubernetes, Controllers.
- Microsoft Azure Architecture Center, Publisher-Subscriber, Sharding, Retry y Circuit Breaker.