Control de frecuencia sobre FreeWheel: por qué las plataformas de streaming construyen el suyo
FreeWheel elige el anuncio de cada corte, pero no ve todos los anuncios que un viewer realmente vio. Por qué plataformas como Pluto TV guardan su propio historial de impresiones y limitan la repetición por encima del ad server, tres formas de construir ese control y el diseño que corre en producción.
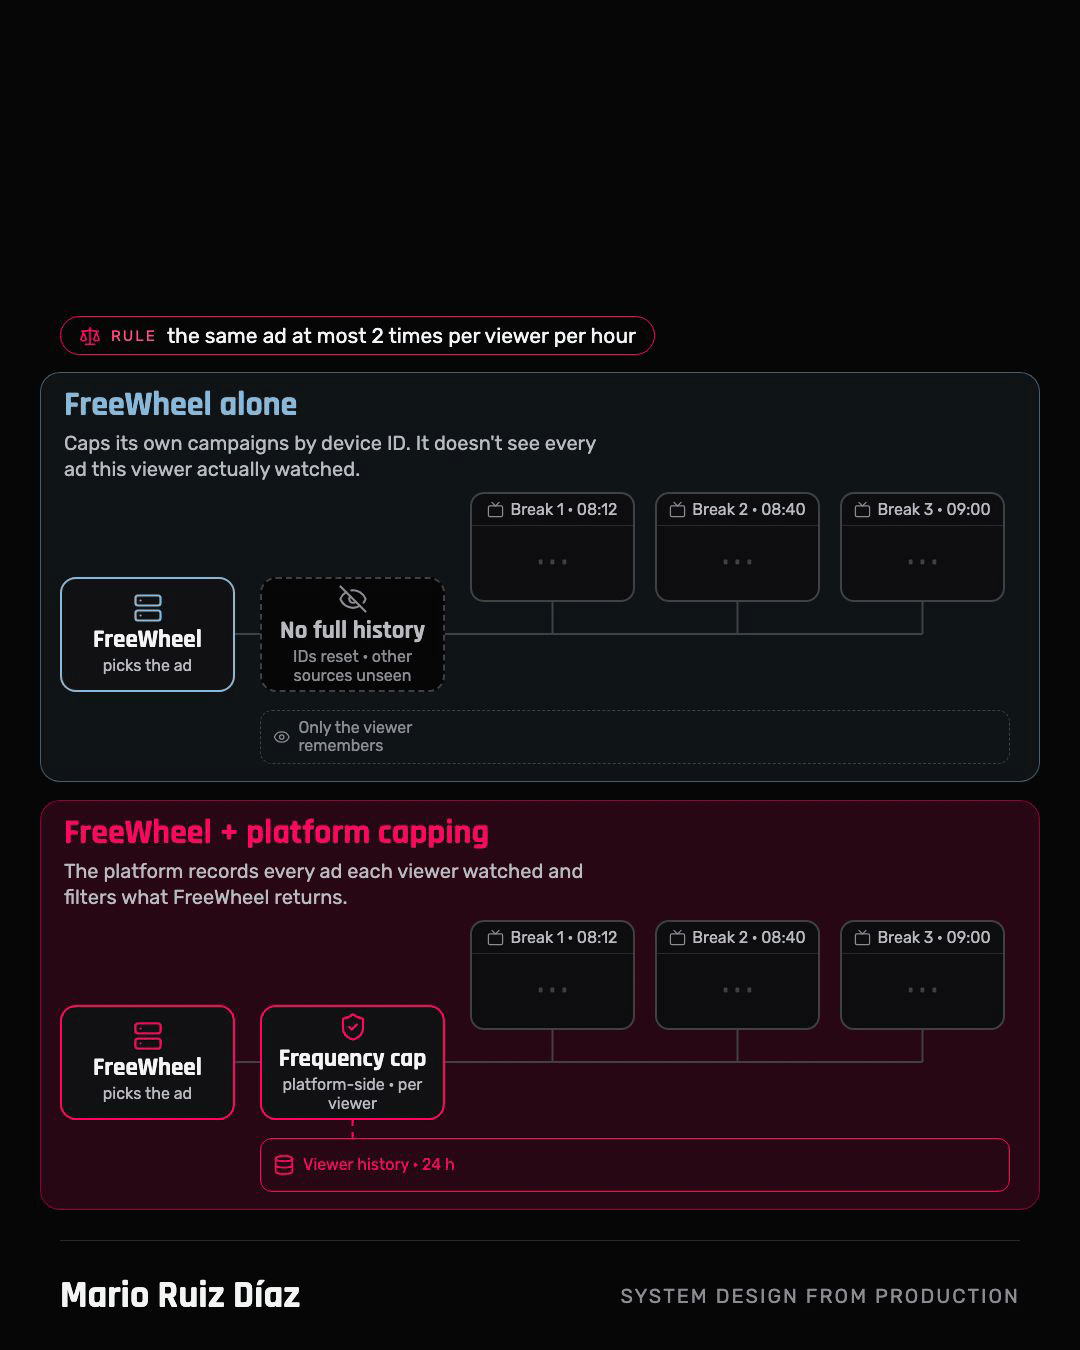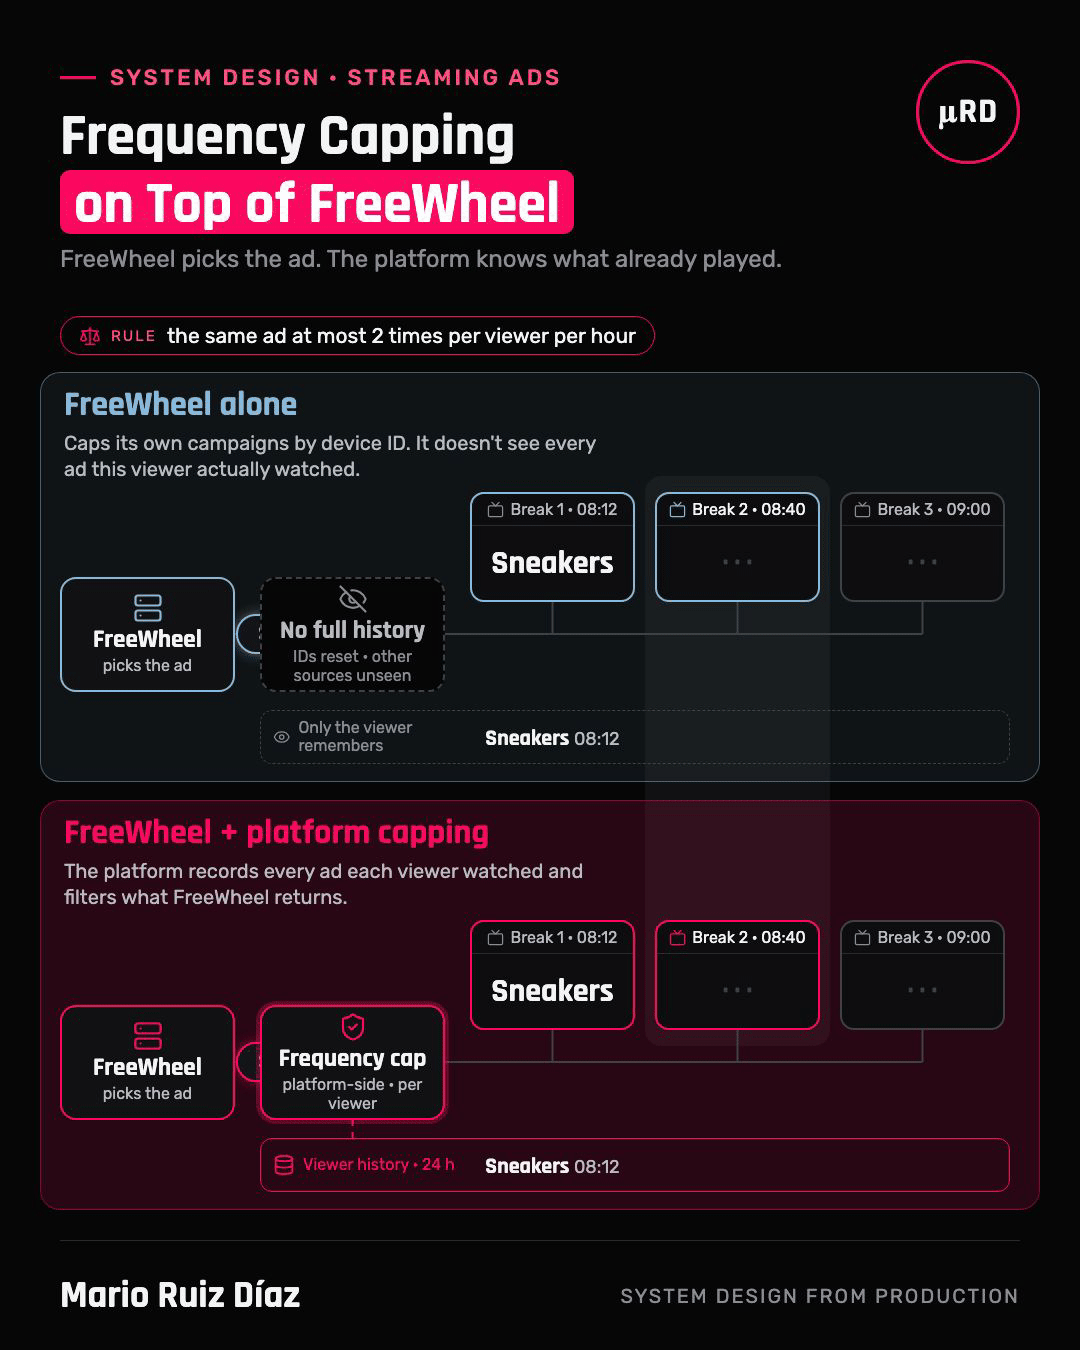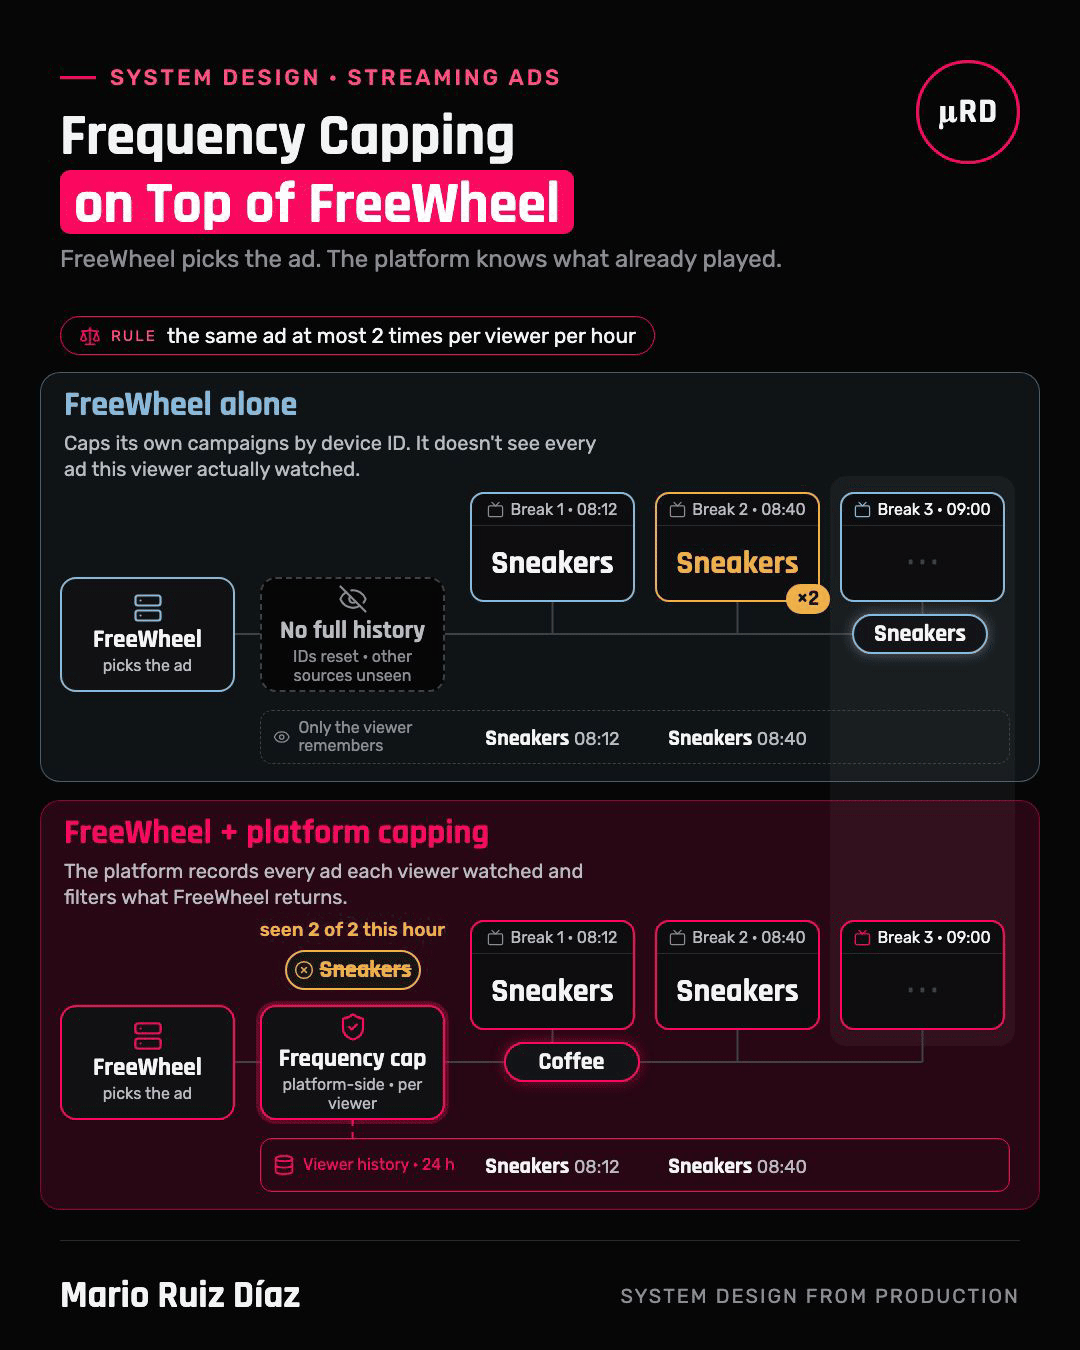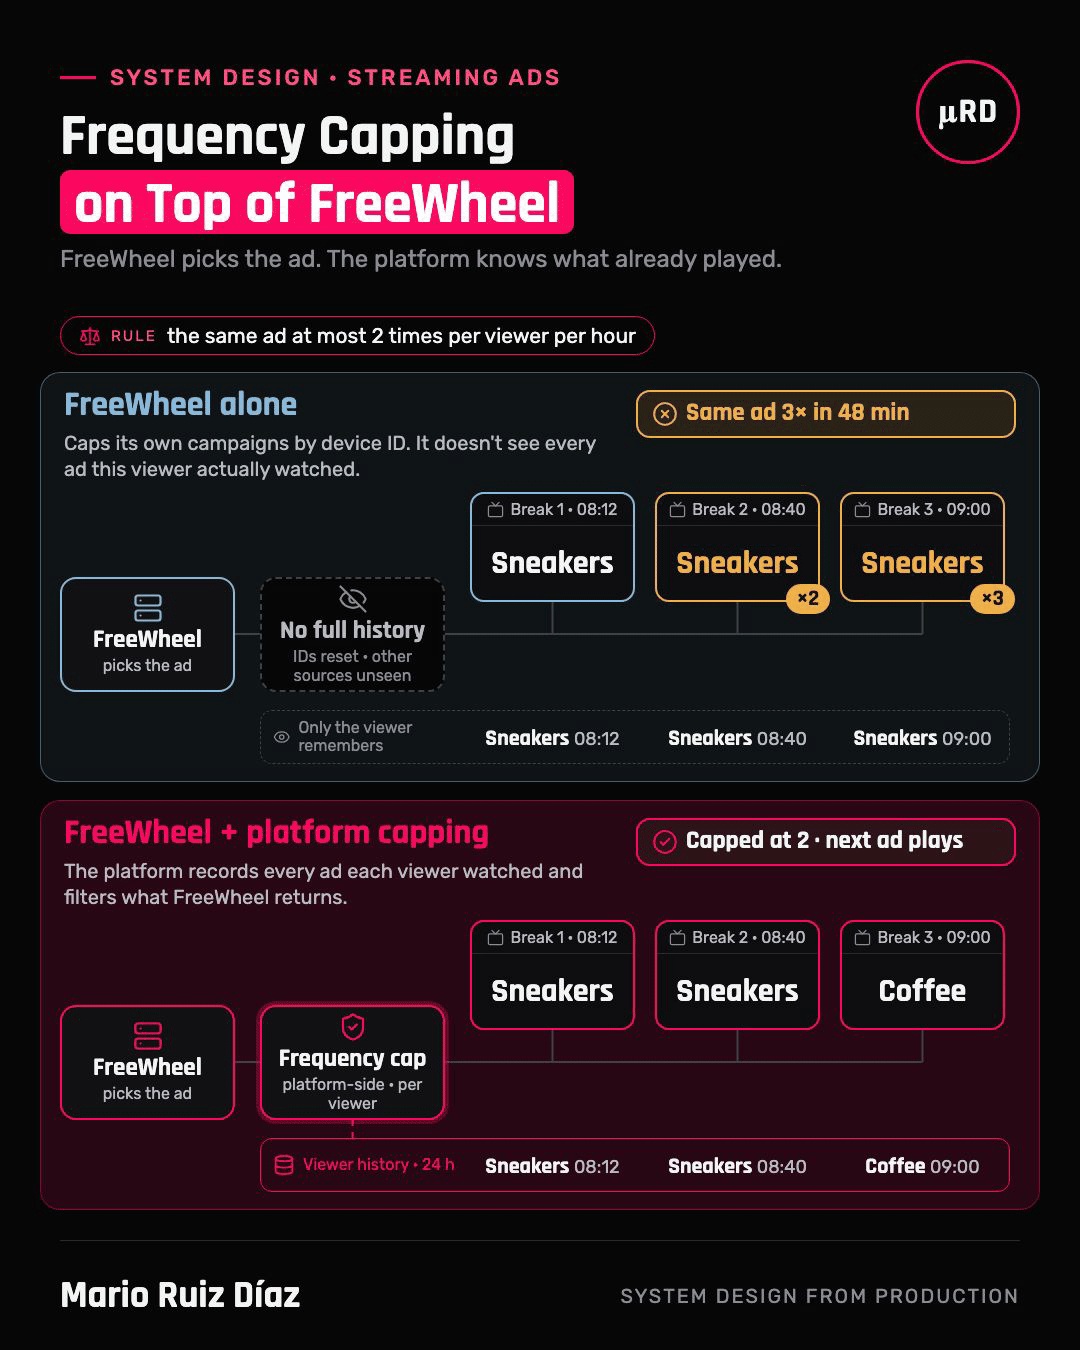
Un viewer está mirando un canal de streaming gratuito. Son las 09:00, está por empezar el tercer corte publicitario de la hora y el servidor de anuncios eligió la misma publicidad de zapatillas que el viewer ya vio a las 08:12, a las 08:40 y a las 08:55.
El servidor de anuncios es FreeWheel, y FreeWheel tiene control de frecuencia. ¿Entonces por qué el mismo anuncio vuelve una y otra vez?
Porque el ad server responde los pedidos que recibe y limita las campañas que sirve con los identificadores que le pasan. Lo que no tiene es el registro completo de lo que este viewer realmente vio. Ese registro vive en la plataforma de streaming, y también el único control que puede usarlo. Este artículo explica dónde cae esa línea y después compara tres formas de construir el control del lado de la plataforma, con el diseño que corre en producción en Pluto TV.
Qué limita FreeWheel y qué no puede ver
Deslizá hacia el costado para ver el diagrama completo →
En el streaming de TV conectada, los anuncios suelen coserse al stream en el servidor (server-side ad insertion, SSAI). El servicio de anuncios de la plataforma le pide al ad server cada corte, recibe candidatos y arma el pod. FreeWheel decide qué anuncio gana cada pedido, y tiene control de frecuencia. Lo que importa es a qué está atado ese control y qué le llega.
Cómo funciona el tope de FreeWheel
Según la referencia de la API para publishers de FreeWheel (Placement API):
- El tope pertenece a lo que se vendió. Se define sobre una campaña, una orden de inserción, un placement o un deal programático, y limita cuántas veces "the ad units in a placement can be served to a viewer" en un período. Tres topes por placement por defecto, hasta diez con una función opcional.
- Los períodos son un menú fijo: diez minutos, hora, día, semana, 30 días, stream, asset, sección del sitio, campaña o una cantidad de minutos. Los períodos largos ya estaban documentados en mayo de 2022 (copia archivada). La referencia pública no dice si el período se desliza con el tiempo o se reinicia, ni en qué instante se evalúa.
- El viewer es el "Identifier from Request": el ID que llega en cada pedido de anuncios. Contar por hogar es una función opcional que tiene que activar el equipo de la cuenta.
- El tope por marca llegó tarde. Hoy existe un tope global por marca como función a nivel de red, del que los placements y deals pueden excluirse. No aparece en la copia completa de 2022 de la referencia y está documentado recién a fines de 2024; en 2023 un ejecutivo de FreeWheel dijo que la empresa había pasado los dos años anteriores construyendo el tope por anunciante y marca (Beet.TV).
- La industria sirve para exclusividad, no para frecuencia. Las industrias y grupos de industria mantienen separados a los competidores dentro de los anuncios de un corte o entre anuncios contiguos. Nada cuenta cuántas veces un viewer vio una categoría de producto en el tiempo.
- No hay tope por creatividad. En la API para publishers, los topes aparecen solo en objetos de venta; las creatividades y los ad units no tienen.
Qué le llega
- El viewer suele ser anónimo. SSAI no tiene cookies, así que el control depende de los identificadores que pasa el publisher (IAB Australia). Cuando un viewer de Roku limita el rastreo publicitario, el ID de publicidad pasa a ser uno temporal que "expires after 30 days" (Roku); en los dispositivos de Apple llega en ceros. Un tope atado a un ID que se reinicia no puede contar entre sesiones, y dos dispositivos son dos viewers.
- Solo cuenta lo que sirvió él. Los cortes también se llenan con demanda programática, acuerdos directos y promos propias, y cada vendedor limita su propia entrega. El ejemplo de Digiday: cuatro exposiciones por día en cada uno de tres servicios "could still lead to 12 views" (Digiday).
- La misma creatividad llega con distintos IDs. Reconocer un anuncio entre fuentes requiere un ID de creatividad compartido, y la adopción es parcial: NBCUniversal encontró que menos del 20% de los anuncios digitales lo traía (IAB Tech Lab).
El resultado se ve en pantalla. En 2023, AdExchanger miró títulos on-demand de Pluto TV y los encontró "rife with ad repetition", con el mismo anuncio hasta cuatro veces en un episodio; Paramount confirmó que usa SSAI en todo su streaming (AdExchanger).
| Regla que nota el viewer | Ad server de FreeWheel para publishers (docs públicas) | Plataforma de streaming |
|---|---|---|
| Misma campaña o placement, X veces por período | Tope nativo, sobre el ID del pedido | Puede aplicarla |
| Misma marca | Tope global por marca, función de red (documentado en 2024) | Puede aplicarla |
| Misma categoría de producto en el tiempo | Solo exclusividad dentro de un corte | Puede aplicarla |
| Misma creatividad, entre campañas y fuentes | Sin tope por creatividad | Puede aplicarla |
| Anuncios de otras fuentes de demanda | No los cuenta | Cada beacon de impresión |
| Ventana evaluada cuando se emite el corte | No documentado | Se decide al momento del corte |
La conclusión no es que FreeWheel sea un mal ad server. Es una cuestión de responsabilidad: el ad server es dueño de la venta y la subasta; la plataforma es dueña del historial del viewer. Si el requisito de producto es "ningún viewer ve el mismo anuncio, marca o categoría más de X veces cada Y minutos", la plataforma tiene que recordar qué vio cada viewer y filtrar lo que devuelve el ad server, antes de que se emita el corte.
El problema
Una plataforma de streaming suele eliminar duplicados dentro de un mismo corte (un ad pod) mientras lo arma. Lo difícil es entre cortes: las últimas 24 horas de anuncios del viewer, de todas las fuentes, con reglas como:
- la misma creatividad como máximo 3 veces cada 60 minutos;
- la misma marca como máximo 5 veces cada 2 horas;
- la misma industria (por ejemplo, seguros de auto) como máximo 2 veces cada 30 minutos;
- una regla específica para una marca que reemplaza a la genérica, o que apaga el control para un sponsor.
Requisitos
- Decidir en el camino de entrega. El servicio de ad pods tiene que saber cuáles de los candidatos del ad server están permitidos mientras llena el corte; el control no puede sumar latencia visible.
- Correcto al momento absoluto del corte. Importa qué impresiones están dentro de la ventana cuando se emite el corte, no cuando se hizo el pedido.
- Reglas como datos. Operaciones de publicidad cambia los topes sin deploys, con un orden de precedencia predecible.
- Entrada por eventos. Las impresiones llegan como eventos desde apps mobile, web y TV, con duplicados, reintentos y demoras.
- Margen. Los eventos en vivo y los estrenos multiplican el tráfico; el diseño tiene que aguantar 10x.
Estimación de escala
A partir del diseño de Pluto TV (métricas de producción del peor caso en seis meses), más supuestos ilustrativos donde se indica:
| Dato | Valor |
|---|---|
| Eventos de impresión en el beacon | ~6.000 por segundo (peor caso) |
| Mensajes en el bus de eventos | ~12.000 por segundo |
| Historial de impresiones | 24 horas por dispositivo, ~120 GB |
| Margen requerido | 10x todo lo anterior |
| Anuncios por corte (ilustrativo) | ~4 |
| Creatividades candidatas por corte (ilustrativo) | ~20 |
| Impresiones por dispositivo en 24 h (ilustrativo) | ~30 |
Eso da:
- ~1.500 decisiones de tope por segundo en el pico (6.000 impresiones ÷ 4 anuncios por corte), y 15.000 por segundo con 10x.
- ~600 comparaciones por decisión si se hace de forma ingenua: 20 creatividades candidatas × 30 impresiones en el historial, antes de aplicar las reglas de marca e industria.
- ~240 bytes por impresión guardada (120 GB sobre unos 500 millones de impresiones por día al ritmo del pico): huella, creatividad, marca, industria y timestamp. Poco por registro, mucho en total, y todo caliente durante 24 horas.
La aritmética ya sugiere la respuesta: el camino de lectura no puede recalcular todo, y el de escritura tiene que absorber miles de eventos por segundo sin acoplarse a él.
Enfoque 1: Query on read
Deslizá hacia el costado para ver el diagrama completo →
En cada corte, el servicio de decisión carga el historial de impresiones del viewer y evalúa cada regla para cada creatividad candidata: cuenta las impresiones de esa creatividad, esa marca y esa industria dentro de la ventana de cada regla, las compara con el tope y devuelve la lista de permitidas.
Dónde brilla
- Exacto por construcción. La decisión sale del historial crudo al momento del corte, así que las ventanas, la precedencia y las reglas nuevas aplican de inmediato.
- Fácil de razonar. Un store, una función, ningún estado derivado que mantener sincronizado.
- Cambiar reglas no cuesta nada. No hay nada precomputado, así que editar una regla nunca obliga a recalcular.
Dónde se rompe
- El costo cae en el camino crítico. Una lectura del historial más cientos de comparaciones por corte, miles de veces por segundo, dentro del presupuesto de latencia del corte.
- Escala con el largo del historial. Los viewers más intensivos tienen los historiales más largos, y son justo los que más hace falta limitar.
- Cada corte paga el cálculo completo, aunque nada haya cambiado desde el anterior.
Enfoque 2: Counters on write
Deslizá hacia el costado para ver el diagrama completo →
Cada impresión incrementa un contador por viewer y creatividad (INCR cap:viewer:creative) con un TTL igual a la ventana (EXPIRE 60 min). El corte solo lee el contador y lo compara con el tope. Es el rate limiter de ventana fija de manual.
Dónde brilla
- Lecturas rápidas. Un
GETpor candidata, tiempo constante. - Barato de construir. Redis, dos comandos, ningún servicio extra.
- Alcanza para un solo tope. Una regla, una dimensión, una región.
Dónde se rompe
- Una ventana fija no es una ventana deslizante. El TTL arranca con la primera impresión y reinicia toda la cuenta de una vez. Un viewer puede ver el anuncio tres veces a las 08:55 y tres más a las 09:01.
- Decide en el momento equivocado. El contador responde "cuántas hay ahora", pero la pregunta es "cuántas hay dentro de la ventana cuando se emite el corte". Los anuncios se piden antes de reproducirse; el mismo historial puede permitir un anuncio a las 09:00 y bloquearlo a las 08:30.
- Cuenta doble. Un reintento del beacon o un evento duplicado incrementa dos veces. Sin una clave de idempotencia por impresión, los contadores derivan hacia arriba y bloquean anuncios que deberían salir.
- Las reglas multiplican las claves. Topes por creatividad, marca e industria, reglas genéricas y específicas, y su precedencia convierten un contador en una familia de contadores que tienen que mantenerse consistentes.
Por qué importa el instante de la decisión
Deslizá hacia el costado para ver el diagrama completo →
Con un tope de 3 cada 60 minutos, el corte de las 09:00 cuenta las impresiones de 08:00 a 09:00: 08:12, 08:40 y 08:55. Son 3 de 3, así que el anuncio se bloquea. A las 09:12, 08:12 ya salió de la ventana: 2 de 3, así que el mismo anuncio se permite. Un diseño que evalúa "ahora" en lugar de "el momento del corte" bloquea anuncios que deberían salir, o emite anuncios que no deberían.
Enfoque 3: Cuotas precomputadas sobre un stream de eventos
Deslizá hacia el costado para ver el diagrama completo →
Se parte el sistema en dos caminos que solo comparten el almacenamiento.
- Camino de escritura. La API de beacons publica un evento
NEW_IMPRESSIONen Kafka por cada anuncio visto. Consumidores independientes lo insertan en un historial de 24 horas por dispositivo, actualizan contadores de cuota de ventana deslizante para cada regla y dimensión que coincide, y limpian las ventanas vencidas. - Camino de lectura. Cuando el servicio de ad pods llena un corte, le pide a un servicio de decisión (adSelection) las cuotas restantes del viewer al momento absoluto del corte y filtra las creatividades candidatas. Si un dispositivo todavía no tiene contadores, el servicio de decisión evalúa las reglas en el momento en lugar de bloquear el corte.
Dónde brilla
- Lecturas rápidas y baratas. El trabajo caro se hace una vez por impresión, fuera del camino crítico; el corte lee estado precomputado.
- Escalado desacoplado. Ingesta, historial, cuotas y limpieza escalan y fallan de forma independiente; los servicios solo conocen el stream de eventos, no entre sí.
- Las reglas siguen siendo datos. El tipo de regla (genérica, específica), la dimensión (creatividad, marca, industria) y un orden de precedencia claro mantienen el comportamiento predecible mientras operaciones lo ajusta.
Dónde se rompe
- Consistencia eventual. Una impresión que todavía está en el stream no se contó; en el borde, un viewer puede ver una repetición de más. El lag de los consumidores se vuelve una métrica de producto.
- Arranque en frío. Un dispositivo nuevo o una regla nueva no tienen contadores; sin el fallback, las decisiones serían incorrectas justo cuando el tráfico se dispara.
- Más piezas. Kafka, consumidores, almacenamiento y jobs de limpieza para operar, monitorear y dimensionar.
Lado a lado
| Query on read | Counters on write | Cuotas precomputadas | |
|---|---|---|---|
| El trabajo se hace | En cada corte | En cada impresión | En cada impresión, fuera del camino crítico |
| Costo de lectura | Historial + cientos de chequeos | Un GET por candidata | Leer cuotas restantes |
| Ventana | Exacta, deslizante | Fija (TTL) | Deslizante, por regla |
| Instante de decisión | Momento del corte | Ahora | Momento del corte |
| Reglas en capas | Fácil | Explosión de claves | Modeladas como datos |
| Duplicados | Visibles en el historial | Cuentan doble | Deduplicados por huella de impresión |
| Riesgo principal | Latencia en el pico | Deriva silenciosa | Lag de consumidores, arranque en frío |
Reglas como datos, con precedencia explícita
Los topes solo son predecibles si el orden de precedencia es explícito:
| Tipo | Dimensión | Ejemplo | Precedencia |
|---|---|---|---|
| Específica | Creatividad | "Este spot: máximo 2 por hora" | La más alta |
| Específica | Marca | "Marca X: OFF" (sponsor) | Reemplaza a la genérica |
| Genérica | Creatividad | "Cualquier creatividad: máximo 3 por hora" | Por defecto |
| Genérica | Marca / Industria | "Cualquier marca: máximo 5 cada 2 horas" | Por defecto |
Las reglas específicas reemplazan a las genéricas, y la creatividad le gana a la marca, que le gana a la industria. Codificarlo una vez, como datos, es lo que permite que operaciones de publicidad cambie los topes sin deploy y sin sorpresas.
Modos de falla
- Eventos duplicados. Los beacons reintentan. Dale a cada impresión una huella y hacé idempotentes sobre ella la inserción en el historial y la actualización de contadores.
- Eventos tardíos. Una impresión llega después de que se decidió un corte posterior. Contá por el momento de la impresión, no por el de llegada, y aceptá que el tope es eventualmente consistente en el borde.
- Desfase de relojes. Los relojes de los dispositivos mienten. Usá timestamps del servidor para las impresiones y la hora programada para los cortes.
- Lag de consumidores en el pico. Un evento en vivo dispara el tráfico y las cuotas se atrasan. Alertá sobre el lag y dimensioná para 10x antes del evento, no durante.
- Arranque en frío. No hay contadores para un dispositivo o una regla nueva. Evaluá las reglas desde el historial en lugar de permitir o bloquear a ciegas.
- Reglas mal configuradas. Un tope genérico en 0 bloquea todos los anuncios. Validá las reglas al guardarlas y mantené un OFF por dimensión.
- Estado sin límite. Las ventanas vencidas que nunca se limpian hacen crecer el almacenamiento para siempre. La limpieza es un consumidor de primera clase, no un cron agregado al final.
Elegir un stack
| Capa | Opciones comunes | Nota |
|---|---|---|
| Bus de eventos | Kafka, Kinesis, Pub/Sub | Particioná por dispositivo para mantener ordenadas las impresiones de un viewer |
| Ventanas deslizantes | Sorted sets de Redis (ZADD, ZCOUNT, ZREMRANGEBYSCORE) | Score = momento de la impresión; contás cualquier ventana en cualquier instante |
| Procesamiento de streams | Consumidores simples, Kafka Streams, Flink | Empezá con consumidores; sumá un framework cuando las ventanas se compliquen |
| Historial | Redis con TTL, DynamoDB con TTL | 24 h de datos calientes, dimensionados con métricas del peor caso |
| Analítica | ClickHouse, BigQuery | Medí topes alcanzados y fill perdido, no solo latencia |
Caso real: control de frecuencia en Pluto TV
Situación. Pluto TV es un servicio de streaming gratuito con publicidad cuyo servicio de ad pods llena cada corte desde FreeWheel. Ya podía eliminar anuncios duplicados dentro de un mismo ad pod, pero no entre pods: un viewer podía ver el mismo anuncio una y otra vez a lo largo de los cortes de una hora, lo que arruina la experiencia de ver. La configuración de FreeWheel que tenía Pluto TV en ese momento no podía expresar las reglas que necesitaba el producto: topes por marca, por categoría de producto o por anuncio específico, reglas genéricas y específicas con precedencia, OFF para un sponsor, o el mismo viewer entre sesiones. Y el historial que necesitaban esas reglas, cada anuncio que cada dispositivo realmente vio, vivía en los eventos de impresión propios de Pluto TV.
Tarea. Extender la deduplicación entre ad pods con un control de frecuencia del lado de la plataforma (el mismo anuncio como máximo X veces cada Y minutos por viewer), configurable con reglas de negocio, decidido al momento del corte en el camino de entrega y alimentado por eventos de impresión de todos los dispositivos a escala de producción.
Acción. Como Tech Lead y diseñador de la solución:
- Diseñé el modelo de reglas: reglas genéricas (repetición por creatividad, marca e industria) y específicas por marca o creatividad, incluido OFF, con un orden de precedencia explícito.
- Diseñé la decisión al momento absoluto del corte sobre cuotas de ventana deslizante, para que el mismo historial pueda permitir un anuncio en un instante y bloquearlo en otro.
- Diseñé la arquitectura como dos caminos desacoplados alrededor de un almacenamiento compartido: una API de beacons que publica eventos
NEW_IMPRESSIONen Kafka, consumidores independientes para historial, cuotas y limpieza, un historial de impresiones de 24 horas en Redis y un servicio adSelection que le devuelve las cuotas restantes al servicio de ad pods para que filtre los candidatos de FreeWheel, evaluando las reglas en el momento cuando un dispositivo todavía no tiene contadores. - Dimensioné el sistema con seis meses de métricas de producción del peor caso: unos 6.000 pedidos de impresión por segundo en el beacon, 12.000 mensajes por segundo en Kafka y cerca de 120 GB de historial, con la implementación obligada a soportar diez veces esos valores.
- Lideré la implementación desde la revisión de diseño hasta producción.
Resultado. Los topes de frecuencia corren en producción en todos los cortes que ve un viewer. La deduplicación pasó de un solo ad pod a 24 horas de impresiones por dispositivo, el camino de escritura está construido para el pico medido con margen de 10x, y operaciones de publicidad cambia las reglas de repetición sin deploys.
La lección que me quedo: poné el control donde vive el historial, decidí en el instante que importa y sacá el trabajo del camino que no puede esperar. Casi todo el diseño sale de esas tres decisiones.
Leé el caso completo: cómo Pluto TV limitó la repetición de anuncios entre cortes →
Por dónde empezar
- Mapeá quién ve qué: qué fuentes de demanda llenan tus cortes, qué IDs le llegan al ad server y dónde queda registrada cada impresión reproducida.
- Escribí las reglas: dimensiones, ventanas, topes y orden de precedencia. El modelo de datos sale de ahí.
- Definí el instante de la decisión: el momento del corte, no el del pedido.
- Empezá con query on read si el tráfico es bajo; medí la latencia de la decisión en el pico.
- Pasá a cuotas precomputadas cuando la lectura se vuelva cara: eventos en un stream, consumidores fuera del camino crítico.
- Hacé idempotente cada escritura sobre una huella de impresión.
- Mantené un fallback para dispositivos y reglas sin contadores.
- Dimensioná con métricas del peor caso y guardá margen de 10x para los eventos en vivo.
La conclusión
El ad server es dueño de la subasta; la plataforma es dueña del historial del viewer, así que el control que protege al viewer va en la plataforma, filtrando lo que devuelve FreeWheel. Construido ahí, un control de frecuencia es un rate limiter cuyo reloj es el corte publicitario. Query on read es exacto pero paga en el peor momento; counters on write es rápido pero deriva; las cuotas precomputadas llevan el trabajo al stream de eventos y mantienen la decisión rápida y correcta en el instante que importa. El precio es consistencia eventual en el borde, y un fallback para cuando los contadores todavía no están.
Referencias
- FreeWheel, Placement API v3 (frequency caps, exclusivity), y la copia archivada de mayo de 2022.
- Beet.TV, Frequency-Capping of Ads Is Key Milestone: FreeWheel's Alex Strickland (2023).
- Roku, Integrating the Roku Advertising Framework.
- IAB Tech Lab, Guidelines for the identifier for advertising (IFA) on OTT platforms.
- IAB Australia, CTV quality: frequency capping, content object and ad formats.
- IAB Tech Lab, How ACIF is transforming creative management in CTV.
- Digiday, Streaming services can't stop showing the same ad repeatedly, putting growth at risk (2019).
- AdExchanger, Pluto TV's ad insertion tech has a frequency problem (2023).
- Stripe, Scaling your API with rate limiters.
- Redis, Sorted sets.
- Apache Kafka, Idempotent producer (
enable.idempotence).