Backpressure: de las entradas a la autopista a Kafka
En el 2000, Minnesota apagó durante ocho semanas los semáforos de las entradas a sus autopistas, y las autopistas se volvieron más lentas, no más rápidas. El semáforo de la rampa estaba protegiendo la ruta. En software a ese semáforo se le dice backpressure. Nueve lugares donde vive, las tres formas en que la señal de frenar llega a la fuente, y dos casos reales: Kafka en Pluto TV y workers con tope en Afterhour.
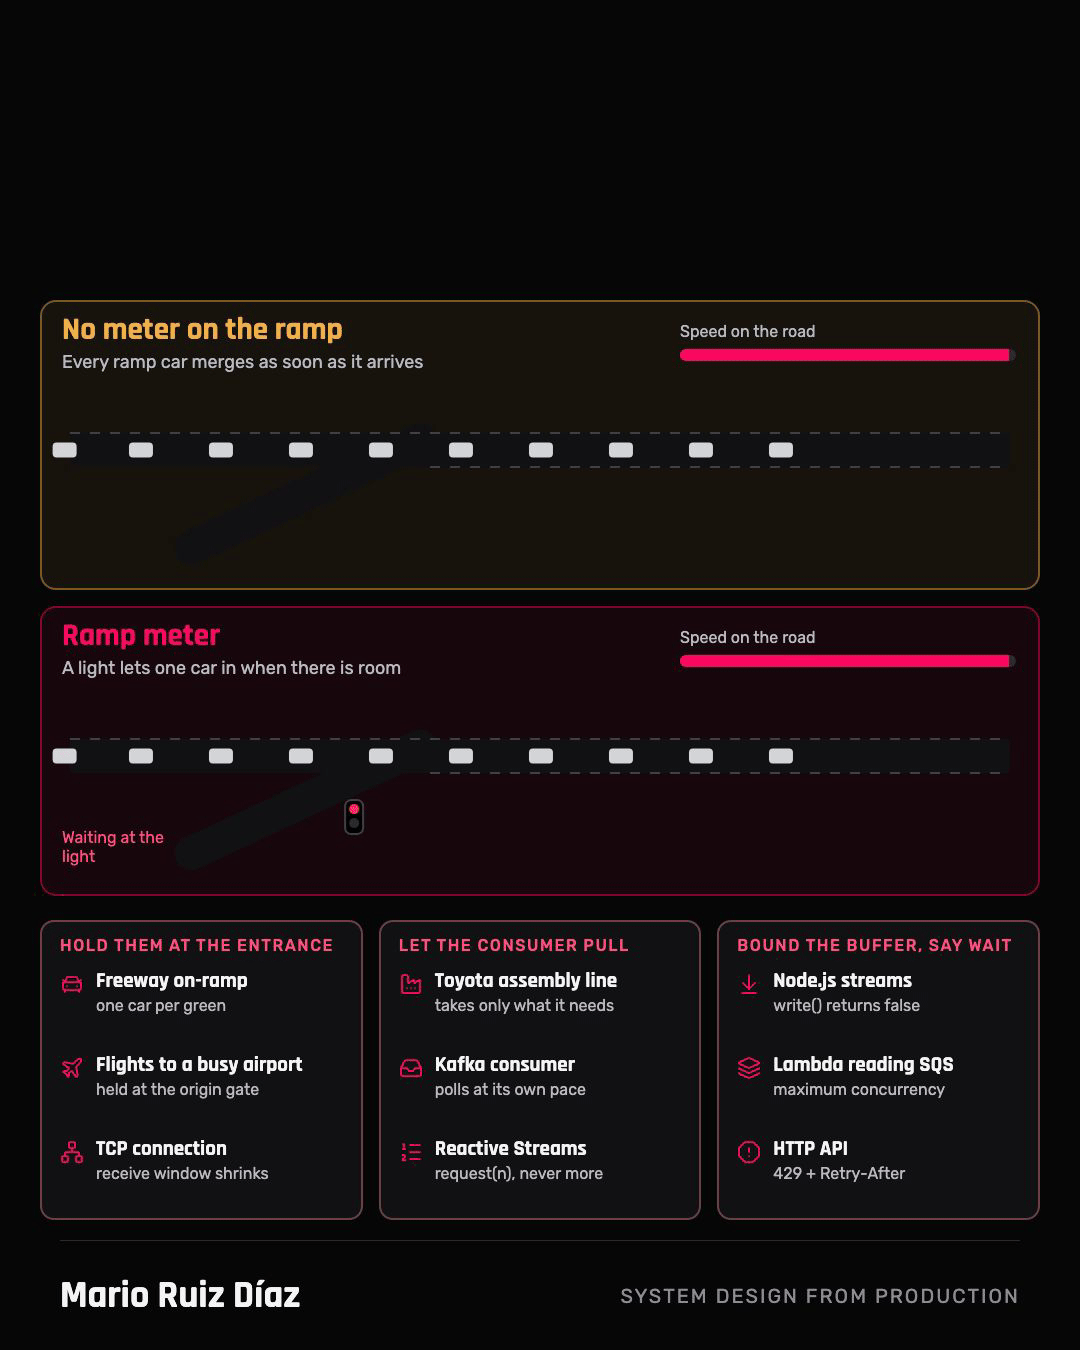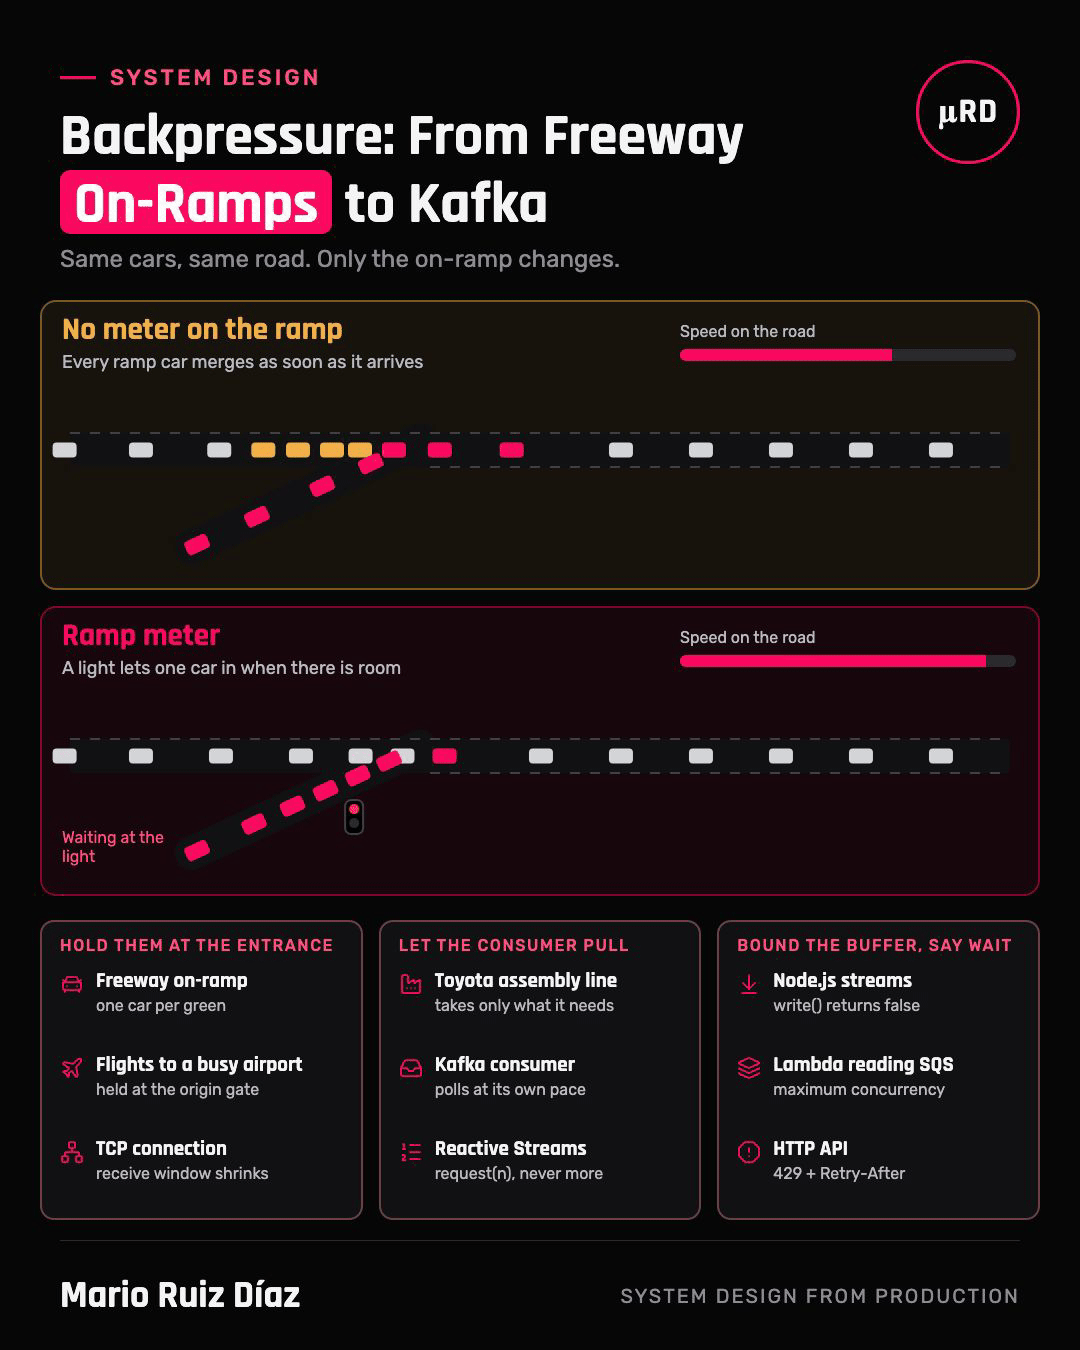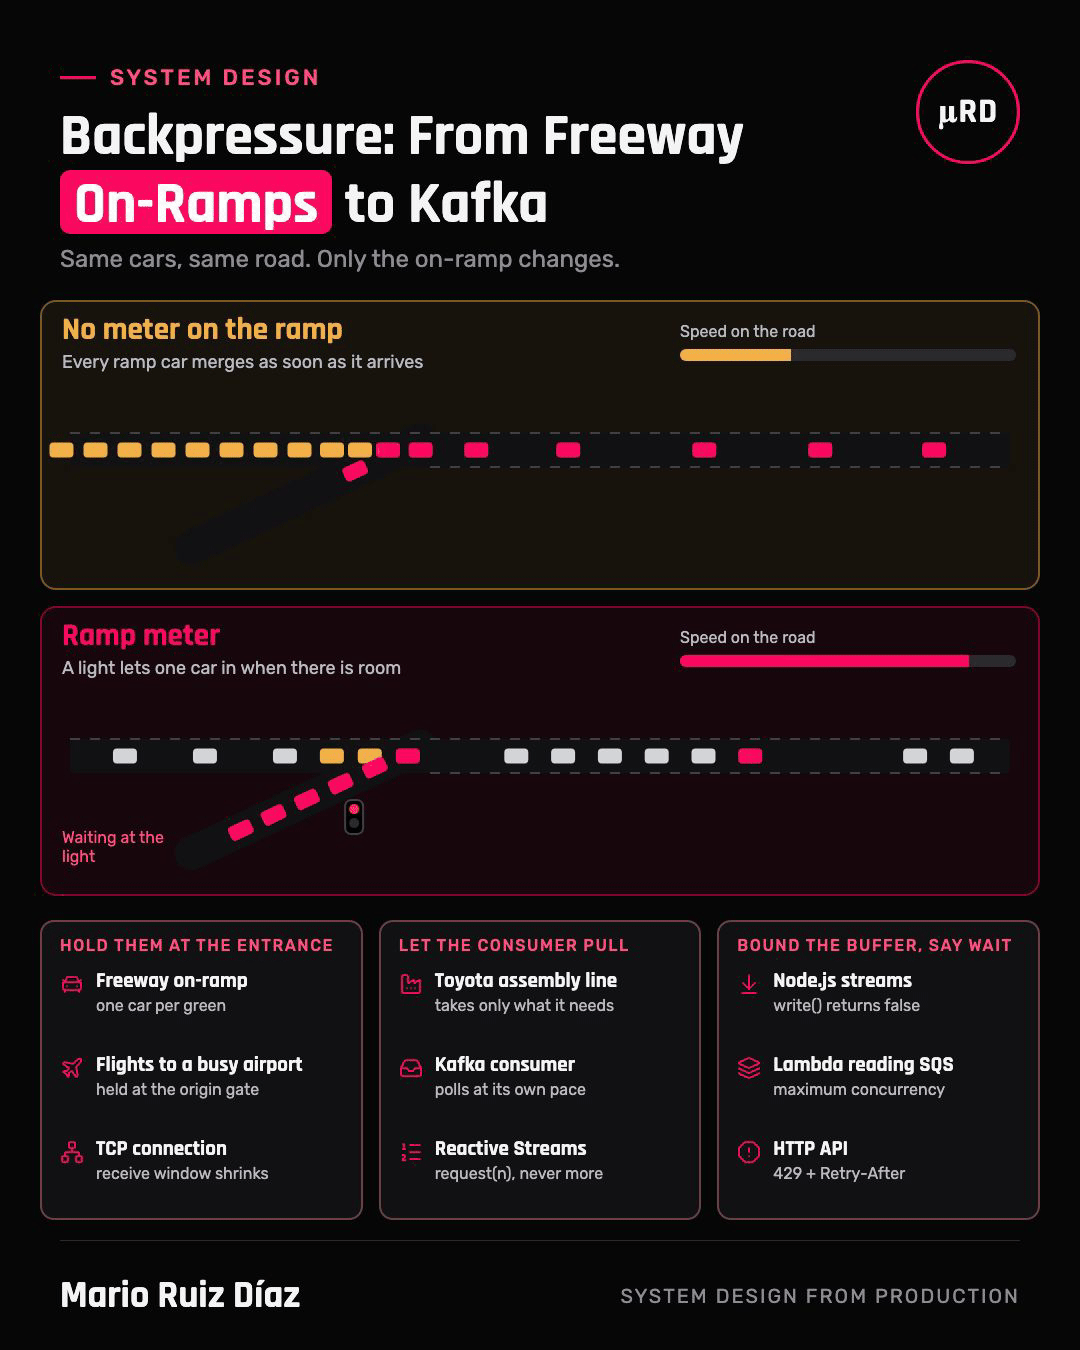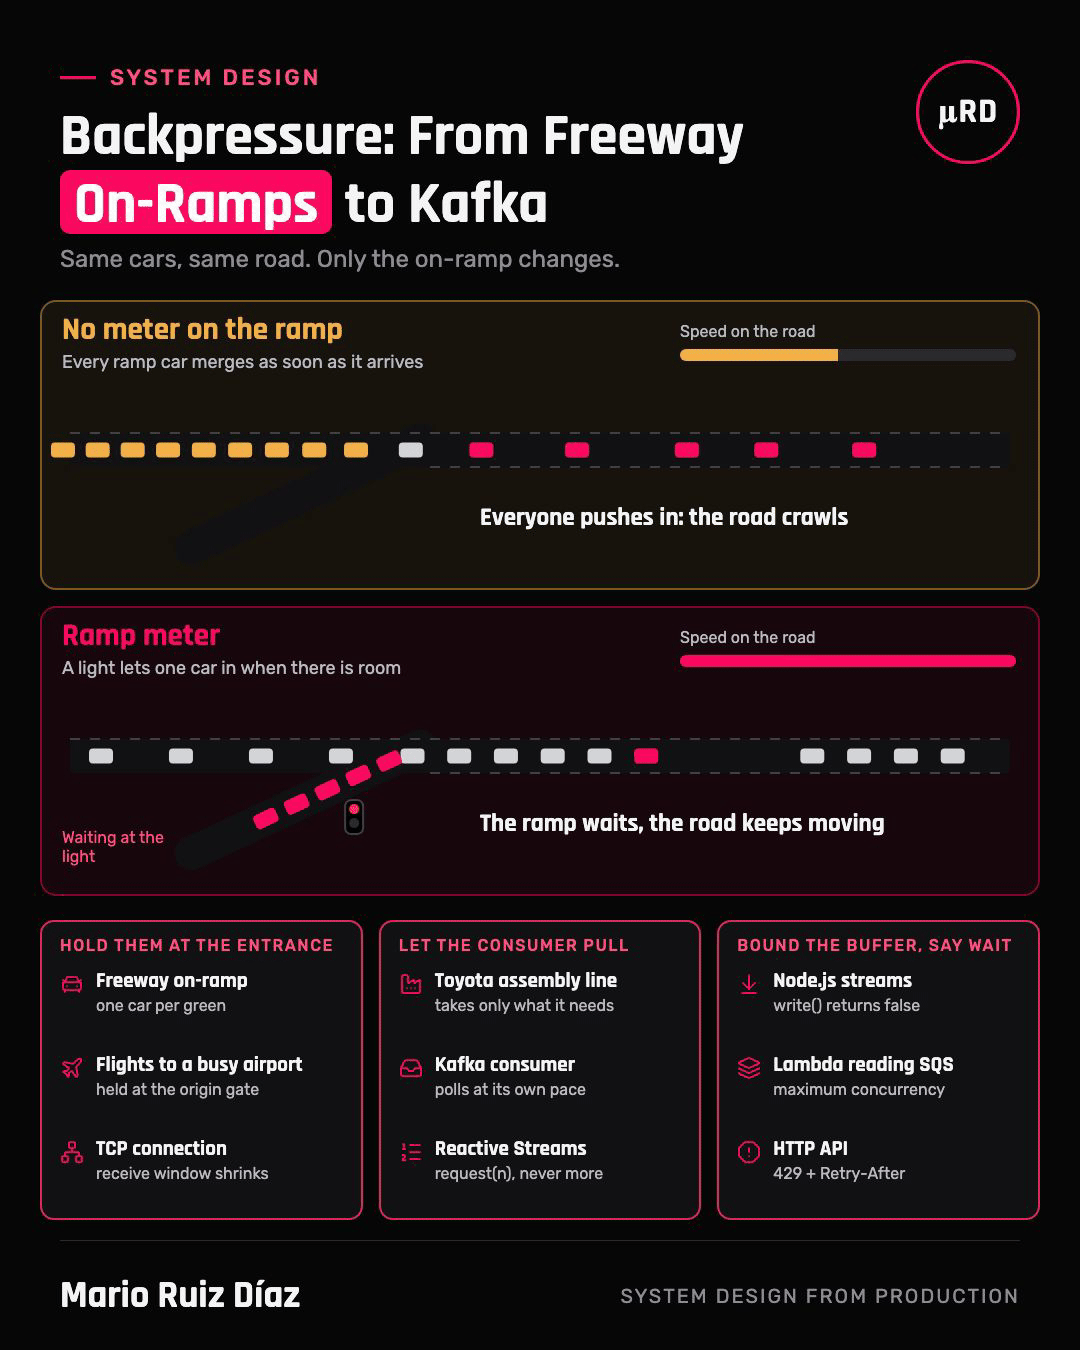
Todos los días hábiles, unos cuantos cientos de semáforos alrededor de Minneapolis y St. Paul hacen esperar a los autos al pie de las rampas de entrada a la autopista. En el 2000 la Legislatura de Minnesota preguntó si valían la pena, y el Departamento de Transporte del estado respondió con un experimento: los apagó todos, en todo el sistema, del 16 de octubre al 8 de diciembre (Mn/DOT, Twin Cities Ramp Meter Evaluation, 2001).
Los autos dejaron de esperar en las rampas. Con los semáforos prendidos, la espera promedio en una rampa con semáforo durante el pico era de 2,3 minutos; sin ellos, prácticamente desapareció. Y las autopistas empeoraron. En el pico de tráfico, la autopista movió un 14% menos, los viajes en los corredores medidos tardaron un 22% más, el tiempo de viaje se volvió casi el doble de impredecible y los choques en el horario pico subieron un 26%. Los semáforos volvieron, menos que antes y con una regla nueva: nadie espera más de 4 minutos en una rampa local (FHWA, caso Twin Cities).
El semáforo de la rampa no estaba haciendo más lento el viaje. Estaba protegiendo la ruta. Cuando cada auto se mete apenas llega, la incorporación se convierte en frenadas, las frenadas en un embotellamiento, y el embotellamiento baja la cantidad de autos que la ruta puede mover. Retener los autos en la entrada, donde esperar es barato, mantenía en movimiento la parte compartida.
En software a ese semáforo se le dice backpressure. Cuando un consumidor no da abasto con lo que le manda su productor, algo tiene que ceder. Sin backpressure, el exceso se acumula donde caiga: en una cola, en memoria, en el pool de conexiones de la base, en una API de terceros, hasta que eso se rompe. Con backpressure, el límite del consumidor se convierte en una señal que viaja hacia atrás, y la fuente baja al ritmo que el sistema realmente puede atender.
Deslizá hacia el costado para ver el diagrama completo →
El detalle importante está en el carril de arriba. Una cola entre el productor y el consumidor parece una solución, porque absorbe la diferencia por un rato. Pero una cola sin límite no es backpressure: solo mueve la sobrecarga a la memoria y posterga la falla. El backpressure empieza cuando algo dice esperá.
Esa señal puede llegar a la fuente de tres formas:
- Frenarlos en la entrada: el recurso compartido le dice a la entrada cuánto lugar queda, y la entrada deja pasar solo eso.
- Que el consumidor tire: nada se mueve hasta que el consumidor lo pide, así que nunca le llega más de lo que pidió.
- Acotar el buffer y decir esperá: entre los dos hay un buffer con límite, y cuando se llena la fuente tiene que esperar, o le dicen que vuelva más tarde.
Deslizá hacia el costado para ver el diagrama completo →
Nueve lugares donde vive el backpressure, agrupados según cómo viaja la señal.
Frenarlos en la entrada
1. Las rampas de entrada a la autopista
La presión. En hora pico, más autos quieren entrar a la autopista de los que la incorporación puede absorber sin frenar.
La señal. Un semáforo de rampa: una luz al pie de la rampa que deja pasar un auto por cada verde, a un ritmo que depende de lo que la autopista puede recibir. La rampa espera para que la ruta no se trabe. El experimento de Minnesota es el caso raro en que alguien midió qué pasa cuando lo sacás.
Dónde se rompe. La rampa tiene su propio límite. Si la fila en la rampa crece tanto que llega a la calle, el problema se movió, no desapareció. Por eso los semáforos de Minnesota hoy limitan la espera a 4 minutos en las rampas locales y dejan de retener autos cuando la fila llega a las calles de la ciudad. Toda señal de backpressure necesita un lugar donde esperar sea barato, y ese lugar también necesita un límite.
2. Los vuelos a un aeropuerto congestionado
La presión. El clima o la falta de personal bajan cuántos aviones puede recibir un aeropuerto por hora, pero los vuelos que van hacia ahí ya están programados.
La señal. La FAA los retiene en el origen. Un Ground Delay Program se usa cuando se espera que la demanda proyectada supere la capacidad de recepción del aeropuerto durante un período largo, y en un Ground Stop los vuelos con destino al aeropuerto afectado quedan retenidos en su punto de partida (FAA, Air Traffic Control System Command Center). Cada vuelo demorado recibe un horario de salida asignado.
Por qué en el origen. Es la misma elección que el semáforo de la rampa: un avión esperando en la puerta le cuesta tiempo a los pasajeros; un avión esperando en el aire sobre un aeropuerto lleno cuesta combustible y margen de seguridad. El backpressure lleva la espera adonde es más barata.
3. Las conexiones TCP
La presión. Un emisor puede mandar bytes mucho más rápido de lo que un receptor ocupado puede leerlos.
La señal. Cada segmento TCP lleva una ventana: el rango de números de secuencia que el receptor está dispuesto a aceptar en ese momento, relacionado con el espacio libre de su buffer (RFC 9293, Transmission Control Protocol). A medida que el buffer del receptor se llena, la ventana se achica; en cero, el emisor se detiene y solo manda pequeñas sondas hasta que la ventana se vuelve a abrir.
Por qué importa. Es backpressure incorporado a la red. También es la razón por la que un lector lento de un lado de un socket termina bloqueando al que escribe del otro lado, incluso entre máquinas distintas.
Que el consumidor tire
4. La línea de producción de Toyota
La presión. En una fábrica, si cada estación produce lo más rápido que puede, el inventario se apila delante de la más lenta.
La señal. Toyota invirtió el flujo. Just-in-Time significa hacer solo lo que el cliente necesita, cuando lo necesita y en la cantidad que necesita, y el proceso siguiente retira las piezas que necesita del depósito del proceso anterior, que después fabrica solo lo suficiente para reponer lo que se llevaron (Toyota, Toyota Production System). La demanda viaja hacia atrás; las piezas, hacia adelante.
Por qué importa. Tirar hace que el ritmo del consumidor sea el ritmo del sistema, por diseño. Nadie necesita mandar una señal de "frená", porque no se mandó nada que no se haya pedido.
5. Los consumidores de Kafka
La presión. Los productores escriben eventos más rápido de lo que algunos consumidores pueden procesarlos, al menos por un rato.
La señal. Los consumidores de Kafka tiran. La documentación de diseño de Kafka explica por qué: en un sistema push, el consumidor tiende a quedar desbordado cuando consume más lento de lo que se produce, mientras que en un sistema pull el consumidor simplemente se atrasa y se pone al día cuando puede (Apache Kafka, Design: push vs. pull). El atraso espera en el log, en disco, y se ve como lag del consumidor.
Dónde se rompe. Atrasarse es seguro solo mientras el log retenga los datos y el negocio tolere la demora. El lag es una deuda: hay que mirarlo, alertar sobre él y saber cuánto tiempo se puede cargar.
6. Reactive Streams
La presión. El código asíncrono (un cliente HTTP, un driver de base de datos, un stream de eventos) puede emitir resultados más rápido de lo que el código que los recibe puede manejar.
La señal. La especificación de Reactive Streams hace explícita la demanda: el subscriber llama a request(n), y las señales onNext del publisher tienen que ser menos o iguales al total de elementos pedidos (especificación de Reactive Streams). Las librerías que la implementan (Project Reactor, RxJava, Akka Streams) llevan ese contrato por cada etapa del pipeline.
Por qué importa. Es el modelo pull como interfaz. Cualquier etapa que ignore la demanda lo rompe para todos los que vienen después.
Acotar el buffer y decir esperá
7. Los streams de Node.js
La presión. Conectar un stream de lectura rápido (un archivo, un socket) a uno de escritura lento.
La señal. Un stream de escritura tiene un highWaterMark, 16 KB por defecto. Cuando su buffer lo supera, write() devuelve false; el de lectura tiene que pausar y retomar con el evento 'drain' (Node.js, Backpressuring in Streams). pipe() y pipeline() lo hacen por vos.
Dónde se rompe. Ignorar lo que devuelve write(). La guía de Node.js lo mide: la misma transferencia de archivo usó unos 1,52 GB de memoria cuando se ignoraba el valor devuelto, contra unos 88 MB cuando se respetaba. Nada falla en el momento; el proceso simplemente se come la máquina.
8. Lambda leyendo de SQS
La presión. Una cola recibe una ráfaga de mensajes, y Lambda, que escala para leerla, arrancaría todos los workers que pueda. Cada worker abre sus propias conexiones a la base y hace sus propias llamadas a otros servicios.
La señal. Desde enero de 2023, a la fuente de eventos de SQS se le puede poner una concurrencia máxima, que limita cuántas invocaciones leen esa cola al mismo tiempo (AWS, What's New, 12 de enero de 2023). Antes, la única forma era la concurrencia reservada de la función, que según AWS venía con un throughput menos consistente y mensajes reintentados por el throttling de la función. Con el tope, la ráfaga se queda en la cola, donde esperar es barato.
Dónde se rompe. El tope protege lo que está detrás de los workers, no la cola. Si el ritmo sostenido de mensajes supera lo que los workers con tope pueden procesar, la cola crece sin fin. Ese caso está en la historia de Afterhour, más abajo.
9. Las APIs HTTP
La presión. Los clientes mandan más pedidos de los que un servicio puede atender.
La señal. 429 Too Many Requests, que puede incluir un header Retry-After indicando cuánto esperar antes de volver a pedir (RFC 6585). Es backpressure a través de un límite de confianza: el servicio no puede hacer esperar al cliente, así que le pide que espere.
Dónde se rompe. Clientes que reintentan enseguida, o todos en el mismo momento. Un 429 solo funciona si el cliente respeta el Retry-After y le suma algo de azar, que es el tema del artículo anterior sobre thundering herd.
Cómo elegir la señal
| Si… | Usá | Ejemplos |
|---|---|---|
| La fuente no la controlás, y esperar antes de entrar es barato | Frenarlos en la entrada | Semáforo de rampa, demora en tierra, control de admisión |
| Controlás los dos lados y el consumidor puede pedir | Que el consumidor tire | Kafka, Reactive Streams, colas de trabajo que los workers consultan |
| La fuente empuja y podés hacerla esperar | Acotar el buffer | Colas acotadas, high-water marks en streams, topes de concurrencia |
| La fuente empuja y no podés hacerla esperar | Decir que no, con un momento para volver | 429 con Retry-After, o descartar carga |
Cómo falla el backpressure
- Una cola sin límite. Esconde el problema hasta que se acaba la memoria, el disco o la paciencia del mensaje más viejo. Todo buffer necesita un límite, y una decisión sobre qué pasa cuando se alcanza.
- Una señal que se corta a mitad de camino. El backpressure tiene que viajar hasta algo que realmente pueda esperar. Un buffer sin límite en cualquier punto del medio (la cola de un thread pool, una lista en memoria, un outbox sin tope) absorbe la señal y la fuente nunca se entera.
- Esperar más de lo que a alguien le importa. Si un pedido espera en una cola más que el timeout de quien lo hizo, el sistema trabaja para nadie. Hay que acotar la espera, no solo el tamaño.
- Una sola fila para lo urgente y lo masivo. Un trabajo masivo y lento delante de uno urgente es backpressure aplicado a lo que no corresponde. Separá los carriles.
- Reintentos que suman presión. Un cliente rechazado que reintenta enseguida convierte un 429 en más carga. Esperá cada vez más, con azar y con un presupuesto.
Casos reales: una cola que espera, y un log que deja atrasarse al consumidor
En Afterhour: workers con tope detrás del webhook de llamadas
Deslizá hacia el costado para ver el diagrama completo →
Situación. Afterhour es una recepcionista telefónica con IA para estudios de abogados, la plataforma que lidero como Principal Engineer. Cuando termina una llamada, el proveedor de voz manda un webhook, y cada llamada se abre en trabajo: guardar y estructurar la llamada, avisarle al estudio, correr sus triggers y sincronizar con su CRM. Las llamadas no terminan a un ritmo parejo, y todo ese trabajo habla con la misma base de datos y con sistemas de terceros.
Tarea. Aceptar rápido cada webhook y no perder nunca una llamada, sin dejar que una ráfaga de llamadas se convierta en una ráfaga de conexiones a la base y de pedidos a terceros.
Acción. El pipeline ya estaba construido así cuando llegué, y seguí construyendo sobre él, así que esto es el diseño tal como corre, leído de su código:
- Primero persistir. El handler del webhook solo guarda el payload crudo y encola el id de la llamada. El camino rápido casi no hace nada, así que puede decirle que sí a todo.
- Dos colas, dos topes. El procesamiento de llamadas, las notificaciones de leads y los triggers van a una cola de SQS de alta prioridad; los resúmenes, exports, emails y el resto van a otra. Lambda las lee de a un mensaje, con una concurrencia máxima de 5 y 10. Una ráfaga de llamadas se convierte en una cola más larga, no en más workers sosteniendo conexiones a la base al mismo tiempo, y el trabajo masivo no puede ponerse delante de una llamada.
- Reintentos que esperan cada vez más. Un job que falla vuelve después de 0 s, 15 s, 30 s, 1 min, 3 min y así hasta 12 horas, con ±20% de azar para que las fallas no vuelvan todas juntas. Después de 16 intentos va a una dead-letter queue en lugar de girar para siempre.
- La misma regla en mis propios scripts. Cuando escribí el job que recuperó las grabaciones de llamadas que faltaban desde el proveedor de voz, corría con un pool de como máximo 3 pedidos concurrentes por defecto, para que un backfill sobre todo el historial de llamadas no pudiera inundar la API del proveedor.
Resultado. La plataforma procesó más de 25.000 llamadas con este pipeline, y el backfill de grabaciones recuperó 833 grabaciones faltantes con cero errores. Los topes dicen cuánta presión deberían sentir a la vez la base y los terceros; la cola absorbe el resto.
En Pluto TV: dejar que el consumidor se atrase
Deslizá hacia el costado para ver el diagrama completo →
Situación. En Pluto TV, un servicio de streaming gratuito financiado con publicidad, fui Tech Lead y diseñé el sistema de frequency capping que evita que los espectadores vean el mismo anuncio una y otra vez. Cada app reporta cada anuncio visto. El peor caso en seis meses de métricas de producción fue de unos 6.000 pedidos de impresión por segundo en el beacon y 12.000 mensajes por segundo en el bus de eventos.
Tarea. Mantener al día 24 horas de impresiones y los contadores de cuota por regla, sin que las apps, ni la API a la que reportan, dependan de qué tan rápido está el storage en ese momento.
Acción.
- El beacon solo publica. La API ad-beacon escribe cada impresión en Kafka y responde. Nunca espera al storage.
- Los consumidores tiran. El escritor de historial y el gestor de cuotas leen de Kafka a su ritmo y escriben en Redis. Si Redis se pone lento, se atrasan, y el atraso espera en Kafka, en disco, exactamente donde el diseño de Kafka dice que tiene que esperar.
- Dimensionado para 10x. El pipeline se construyó para soportar diez veces el peor caso medido en producción, así que atrasarse es la excepción, no el modo normal de operar.
- El precio se conoce. Mientras los consumidores van atrasados, los contadores de cuota también. El camino de entrega lee contadores precalculados por esos consumidores, así que un atraso significa que, por un rato, a un espectador se le podría permitir una repetición más que el límite. Ese es el trato: un poco de desactualización a cambio de no frenar nunca a las apps.
Resultado. Los frequency caps llegaron a producción en todos los cortes que ve un espectador, alimentados por ese camino de escritura. La lección que me quedo de los dos sistemas: decidí dónde se espera antes de que lo decida el tráfico, y asegurate de que ese lugar tenga un límite.
Leé el caso completo: frequency capping para los anuncios de Pluto TV → · Y la plataforma de Afterhour →
Para llevarse
El backpressure no se trata de ir más lento. Las autopistas de Minnesota movieron más autos con los semáforos prendidos que apagados. Se trata de elegir dónde se espera: en una rampa en lugar de en la ruta, en una puerta de embarque en lugar de en el aire, en un log en lugar de en una base de datos, en una cola con límite en lugar de en memoria sin límite. Buscá lo más lento de lo que depende tu sistema, seguí el camino hasta la fuente, y asegurate de que un "esperá" pueda viajar todo el recorrido.
Referencias
- Minnesota Department of Transportation / Cambridge Systematics, Twin Cities Ramp Meter Evaluation, Executive Summary (2001); FHWA, caso de estudio de los semáforos de rampa de Twin Cities.
- FAA, Air Traffic Control System Command Center: Ground Delay Programs y Ground Stops.
- IETF, RFC 9293: Transmission Control Protocol (2022).
- Toyota, Toyota Production System.
- Apache Kafka, Design: the consumer, push vs. pull.
- Especificación de Reactive Streams para la JVM.
- Node.js, Backpressuring in Streams.
- AWS, AWS Lambda now supports Maximum Concurrency for Amazon SQS as an event source (2023).
- IETF, RFC 6585: Additional HTTP Status Codes (2012).