Thundering Herd: de los apagones a los cortes publicitarios
Cuando vuelve la luz después de un apagón, todas las heladeras y los aires arrancan en el mismo segundo, y la red se puede volver a caer. El software tiene la misma falla: vence una key del cache, se reinicia un servidor, el reloj marca medianoche, y todos los clientes actúan a la vez. Nueve lugares donde aparece la manada, las cuatro salidas, y cómo Pluto TV se adelantó a sus cortes publicitarios.
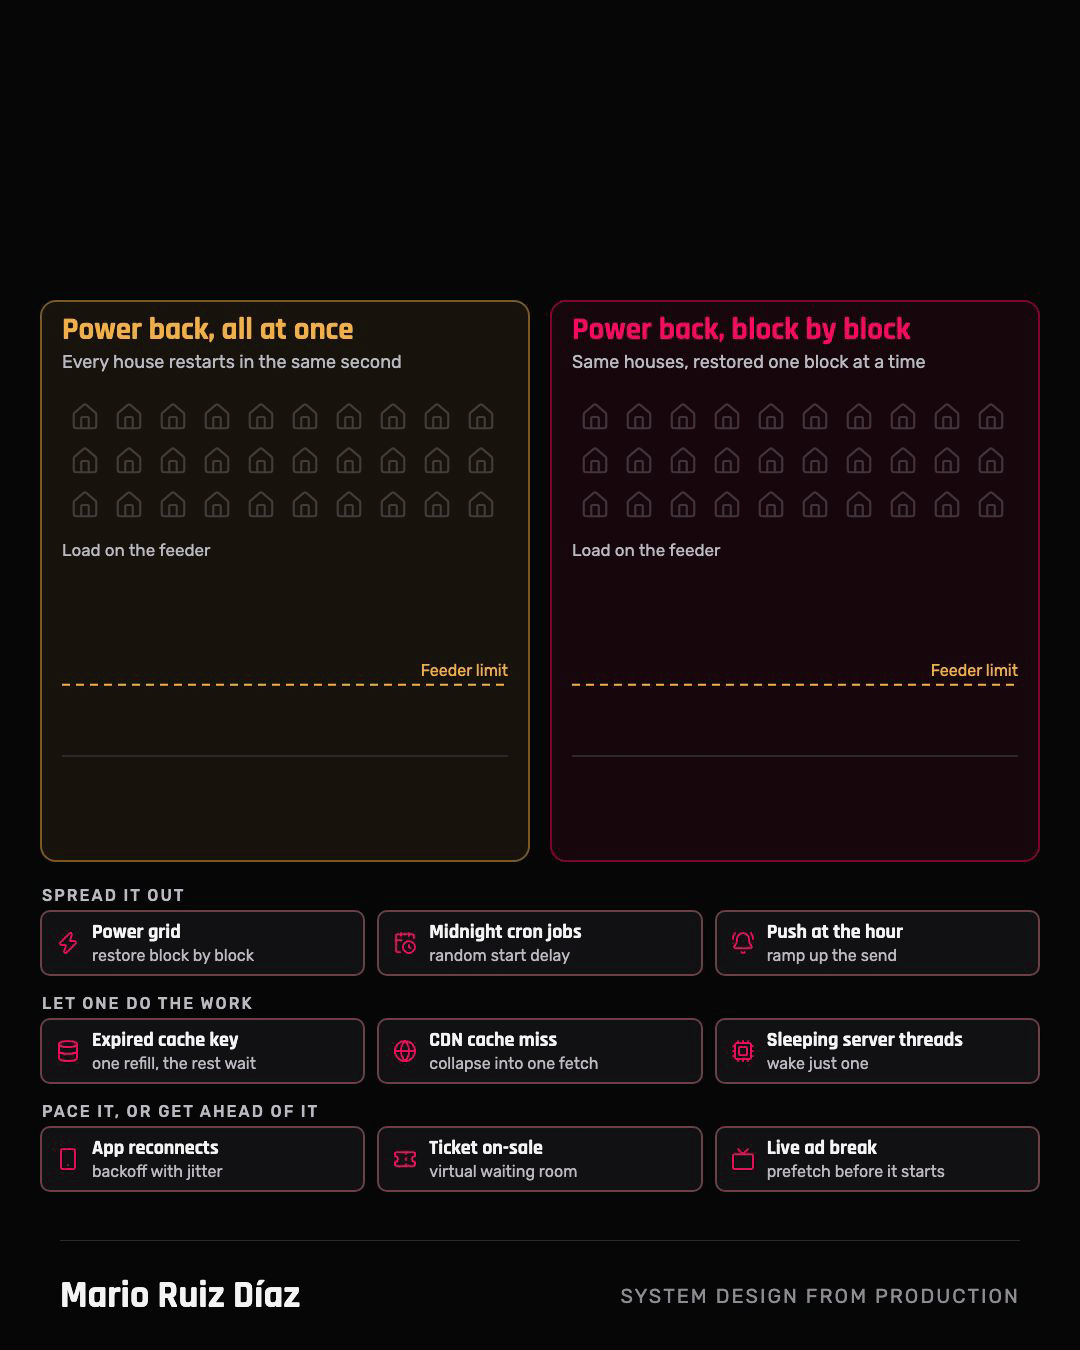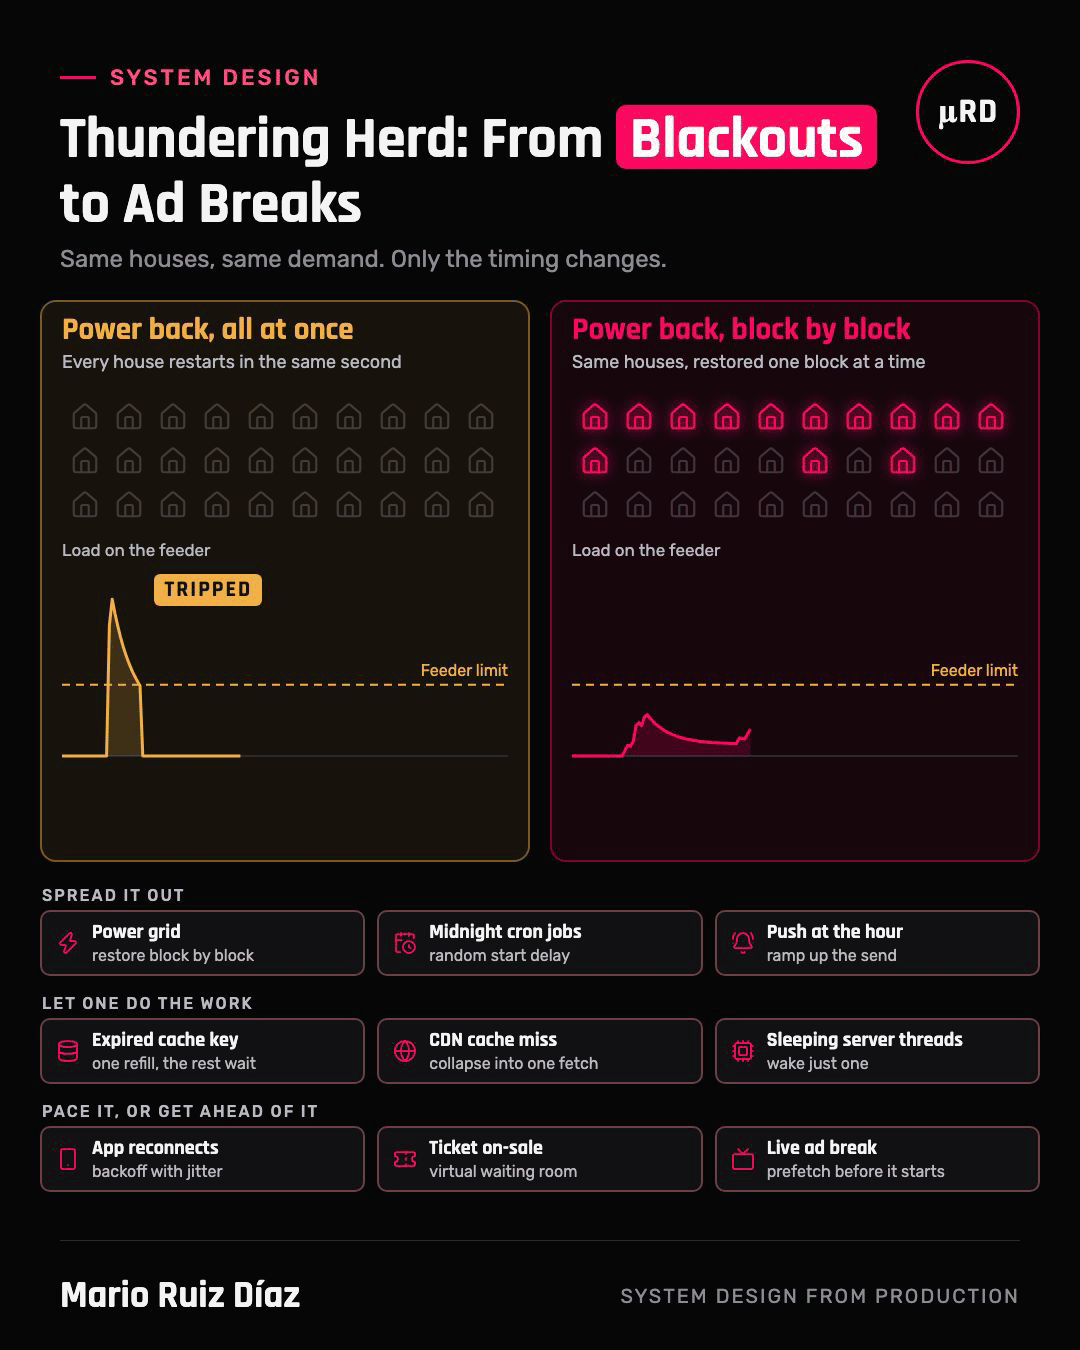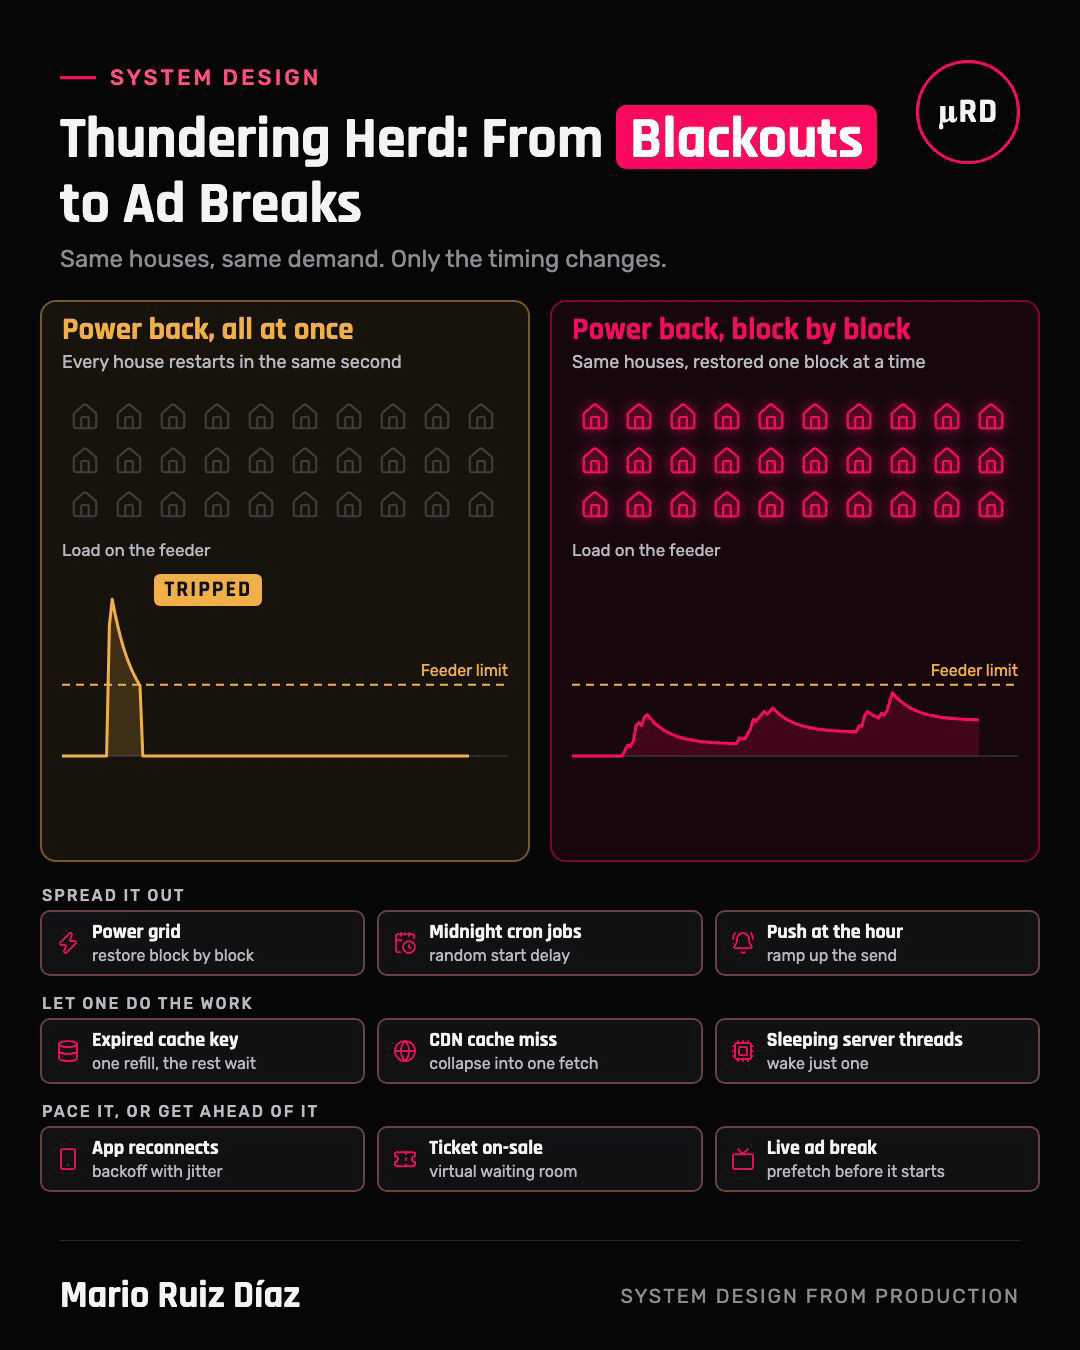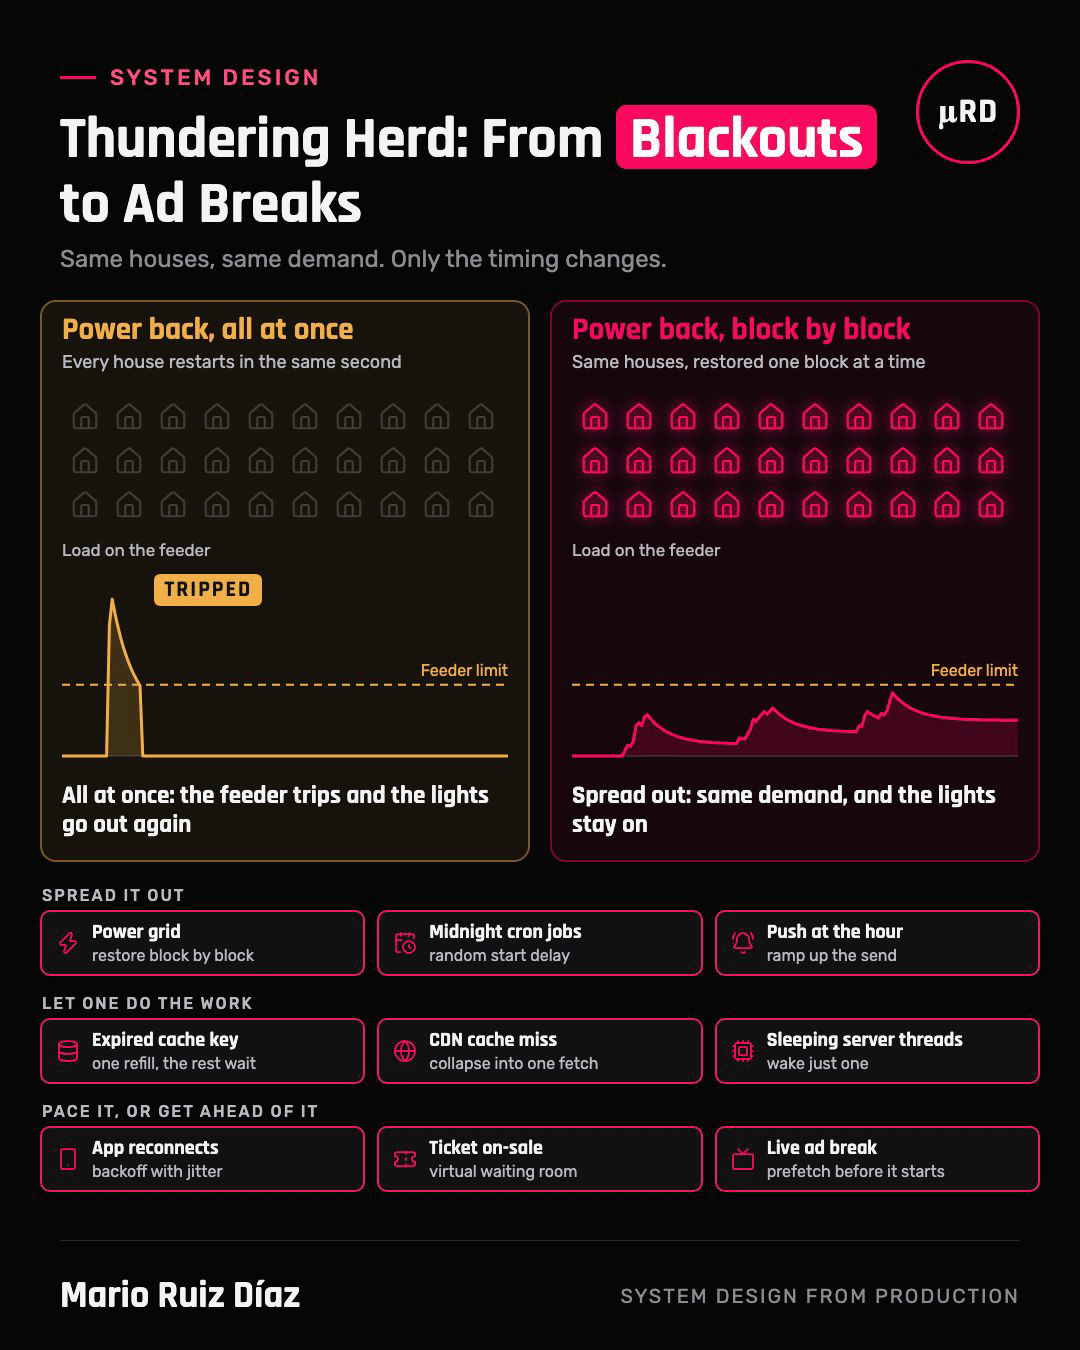
Después de un apagón largo, la luz no vuelve simplemente. Cuando la distribuidora vuelve a energizar un alimentador, todas las heladeras, freezers y aires acondicionados conectados estuvieron apagados el tiempo suficiente como para querer arrancar, y arrancan todos juntos. Un paper del Pacific Northwest National Laboratory describe la carga resultante como significativamente más alta que antes del corte, incluso por encima del pico de demanda normal del alimentador, y la mitigación estándar es restablecer el alimentador por sectores (Schneider et al., IEEE Trans. Power Systems, 2016). Los ingenieros eléctricos lo llaman cold load pickup. Una guía de protecciones de GE estima la corriente de arranque de los primeros segundos en unas cuatro veces la corriente de pico normal, y explica que reconectar después de un corte largo mete todas esas cargas a la vez "sin la diversidad habitual" (GE Vernova, GET-6450).
Sin la diversidad habitual es todo el problema en cuatro palabras. En una noche normal, las heladeras arrancan en momentos al azar y su carga se promedia. Después de un apagón, el corte las sincronizó.
El software lo llama thundering herd, la estampida: un disparador, muchos clientes que reaccionan en el mismo instante, y un recurso compartido que se dimensionó para su promedio, no para todos a la vez. Es el espejo del artículo anterior sobre debounce y throttle. Ahí, un actor dispara muchas veces y el sistema quiere una sola acción. Acá, muchos actores disparan una vez cada uno, en el mismo momento, y el sistema necesita que no lo hagan.
Deslizá hacia el costado para ver el diagrama completo →
Todas las soluciones cambian cuándo llegan los clientes o cuántos llegan de verdad al recurso compartido. Ninguna cambia lo que los clientes quieren. Se agrupan en cuatro familias:
- Repartir: hacer que las llegadas sean aleatorias o escalonadas, para que dejen de coincidir.
- Que lo haga uno: cuando todos quieren lo mismo, uno lo busca y el resto comparte el resultado.
- Dosificar: hacer que los clientes esperen, o dejarlos pasar al ritmo que el sistema puede atender.
- Adelantarse: hacer el trabajo caro antes del momento en que llegan todos.
Nueve lugares donde aparece la estampida, agrupados por la solución que la doma.
Repartir
1. La red eléctrica
La estampida. Los aparatos con termostato, que normalmente arrancan al azar, arrancan juntos cuando vuelve la luz, porque el corte los dejó a todos en el mismo estado.
La solución. Restablecer el alimentador por sectores, para que el arranque de cada sector se estabilice antes de que el siguiente sume el suyo. La demanda total es la misma; solo cambia el momento. Es la imagen del visual al principio de este artículo.
2. Los cron jobs de medianoche
La estampida. La gente elige horas redondas. El libro de SRE de Google lo describe sin vueltas: tantos equipos programan tareas a medianoche que eso provoca un thundering herd y picos sustanciales en el uso del datacenter (Google SRE book, Distributed Periodic Scheduling with Cron).
La solución. Google agregó un valor ? a la sintaxis de su crontab: la tarea indica que no le importa el minuto exacto, y el sistema elige uno calculando un hash de la configuración de la tarea, lo que reparte las tareas de forma pareja. En una sola máquina Linux, los timers de systemd ofrecen RandomizedDelaySec=, que agrega una demora aleatoria para que los timers configurados igual no disparen todos juntos (systemd.timer). Su valor por defecto es 0, así que hay que pedirlo.
Dónde no alcanza. Las tareas atadas a una hora externa real (la apertura del mercado, un reporte que tiene que estar a las 9:00) siguen coincidiendo. Para esas sirven las otras familias.
3. Las notificaciones push a la hora en punto
La estampida. Los equipos de marketing también programan envíos a la hora en punto. Firebase lo dice claramente: FCM recibe más del doble de tráfico en los primeros 30 segundos a 2 minutos de cada hora (Firebase, scaling FCM).
La solución. Firebase recomienda evitar los dos minutos alrededor de :00, :15, :30 y :45, y subir un envío grande de cero a la velocidad máxima en al menos 60 segundos. El mismo consejo protege tu propio backend: una notificación que llega a diez millones de teléfonos a la vez puede meter a una buena parte de ellos en tu app en el mismo minuto.
Que lo haga uno
4. La key del cache que vence
La estampida. Vence una key muy pedida, y todos los pedidos que la necesitaban fallan el cache en el mismo instante y van a la base de datos por el mismo valor. Es el cache stampede.
La solución. El paper de memcache de Facebook describe los leases: ante un miss, el cache le da un token a un solo cliente, como mucho una vez cada 10 segundos por key, y les dice a los demás que esperen un momento y vuelvan a consultar el cache. Solo quien tiene el token recarga la key. En una semana de mediciones sobre keys propensas a la estampida, el pico de consultas a la base bajó de 17.000 por segundo a 1.300 (Nishtala et al., Scaling Memcache at Facebook, NSDI 2013).
Deslizá hacia el costado para ver el diagrama completo →
O refrescar antes de que venza. Una segunda técnica pertenece a la familia de adelantarse: recalcular una key caliente un poco antes de que venza, en un momento aleatorio que se vuelve más probable a medida que se acerca el vencimiento. Vattani et al. demuestran que un refresco anticipado con distribución exponencial es óptimo y lo llaman XFetch (PVLDB, 2015). Cada servidor decide por su cuenta, y el azar evita que todos decidan a la vez.
5. El miss de la CDN
La estampida. Vence un objeto popular en el borde, y una ráfaga de espectadores lo pide antes de que vuelva la primera consulta al origen.
La solución. Request collapsing: la CDN combina varios pedidos del mismo objeto en un solo pedido al origen y les responde a todos con esa única respuesta, lo que evita una avalancha inmediata de pedidos al servidor de origen (Fastly, request collapsing). Dentro de una aplicación, el paquete singleflight de Go hace lo mismo: garantiza que haya una sola ejecución en curso por key y le entrega el resultado a cada uno que lo pidió (pkg.go.dev).
6. Los threads dormidos del servidor, de donde viene el nombre
La estampida. El término viene de los sistemas operativos. Muchos procesos esperan una conexión nueva en el mismo socket; llega una, el kernel los despierta a todos, uno gana, y el resto vuelve a dormir después de gastar CPU para nada.
La solución. Despertar a uno solo. Linux 4.5 agregó EPOLLEXCLUSIVE, que la página de manual describe como útil para evitar problemas de thundering herd en ciertos escenarios (epoll_ctl(2)). El patch original vino de un ingeniero de Akamai, una empresa que sabe algo de muchos clientes llegando a la vez (LWN, 2015).
Dosificar, o adelantarse
7. Las apps que se reconectan después de una caída
La estampida. El servidor se cae, todos los clientes se dan cuenta en segundos, y cuando vuelve se reconectan todos en el mismo segundo, lo que lo puede volver a tirar. En octubre de 2017, un deploy de Slack desconectó a todos sus clientes y los dejó sin poder reconectarse; la solución fueron límites de ritmo para permitir una reconexión gradual (Slack status, 2017-10-31).
La solución. Backoff exponencial con jitter. El backoff solo no ayuda mucho: los clientes que fallaron juntos esperan juntos y vuelven juntos. La simulación de Marc Brooker en AWS muestra que el backoff exponencial sin jitter "es el claro perdedor", y que agregar azar a la espera reduce el trabajo total a menos de la mitad con 100 clientes compitiendo (AWS Architecture Blog, 2015). El libro de SRE de Google lo convierte en regla: usar siempre backoff exponencial aleatorio al programar reintentos (Addressing Cascading Failures). El mismo capítulo muestra por qué los reintentos también necesitan un presupuesto: tres capas que reintentan tres veces cada una convierten un pedido del usuario en 64 intentos.
La idea es más vieja que la web. El paper de Ethernet de 1976 ya resolvía las colisiones haciendo que cada estación esperara un intervalo aleatorio cuya media se duplica después de cada colisión, y lo llamaba binary exponential backoff (Metcalfe & Boggs, CACM 1976).
Kubernetes se aplica el mismo ritmo a sí mismo: un contenedor que se sigue cayendo se reinicia con una demora exponencial (10 s, 20 s, 40 s, …) con un techo de 300 segundos (Kubernetes, Pod lifecycle).
8. La venta de entradas
La estampida. Las entradas salen a la venta a las 10:00, y todos llegan a las 9:59. A diferencia de un cron, el momento no se puede mover: el momento es el producto.
La solución. Una sala de espera virtual dosifica las llegadas en lugar de repartirlas. Queue-it describe un diseño: quienes llegan antes esperan en una pre-cola sin lugar asignado; cuando abre la venta, todos los de la pre-cola se ordenan al azar, como en un sorteo, los que llegan después se suman en orden, y el sitio de venta admite gente al ritmo que puede atender (Queue-it). El sorteo además elimina el motivo para apretar F5 a las 9:59:59.
Deslizá hacia el costado para ver el diagrama completo →
9. El corte publicitario en vivo
La estampida. En un stream en vivo o lineal, todos los espectadores de un canal llegan al corte en el mismo segundo, y todos los reproductores necesitan anuncios para ese corte a la vez. AWS Elemental MediaTailor documenta el prefetch justamente para esto: ayuda a reducir el pico de carga sobre los ad decision servers y la latencia de entrega del manifiesto al inicio de cada corte, y mitiga la menor tasa de llenado causada por timeouts de pedidos de anuncios y de transcodificación (AWS MediaTailor, prefetching ads).
La solución. Adelantarse: buscar y preparar los anuncios antes del corte, para que el corte lea del storage en lugar de llamar a los ad servers todos a la vez. Es el único lugar de la lista donde construí la solución en producción, así que tiene su propio caso más abajo.
Cómo elegir la salida
| Si el momento… | Y los clientes… | Usá |
|---|---|---|
| se puede mover | no necesitan una hora exacta | Repartir: jitter, hashing, sectores (cron, envíos, red eléctrica) |
| no se puede mover | quieren todos lo mismo | Que lo haga uno: leases, request collapsing, singleflight |
| no se puede mover | quieren cada uno algo distinto | Dosificar: backoff con jitter, sala de espera, rate limits |
| es predecible | necesitan algo caro | Adelantarse: prefetch, pre-escalar, refrescar antes |
Cómo fallan las soluciones
- Backoff sin jitter. Los clientes que fallaron juntos esperan lo mismo y vuelven a fallar juntos. El arreglo es el azar; el exponente solo no alcanza.
- Reintentos en todas las capas. Los reintentos de cada capa multiplican los de abajo. Reintentá en una sola capa, con presupuesto.
- El dueño del lease que se muere. Si el cliente que tiene el lease se cae, todos esperan una recarga que nunca llega. Los leases necesitan un timeout; por eso los de Facebook se entregan como mucho una vez cada 10 segundos por key.
- Hacer prefetch de lo que no era. Adelantarse solo funciona si podés predecir el momento y la demanda. Un pronóstico errado, en el mejor caso, desperdicia trabajo y, en el peor, sirve resultados viejos, así que la predicción necesita un ciclo de realimentación.
- Arreglar la estampida y olvidarse del límite. Las cuatro familias compran tiempo y suavidad; ninguna crea capacidad. Si la demanda estable después del pico supera el límite, igual tenés que escalar.
Caso real: adelantarse a los cortes publicitarios en Pluto TV
Deslizá hacia el costado para ver el diagrama completo →
Situación. Pluto TV es un servicio de streaming gratuito financiado con publicidad, con canales lineales: los espectadores de un mismo canal llegan a cada corte en el mismo momento. Sus revenue services deciden, buscan y preparan los anuncios de cada corte, llamando a ad servers de terceros y a una plataforma externa de transcodificación. La oferta de anuncios era limitada y distintas plataformas competían por los mismos anuncios, así que el momento de mayor demanda era también el momento en que más costaba conseguirlos.
Tarea. Asegurar que los cortes con más demanda prevista se llenaran, sin depender de una ráfaga de llamadas a los ad servers en el segundo exacto en que empezaba cada corte.
Acción.
- Pronosticar la demanda. Un pronóstico estadístico elegía los puntos que se esperaba que tuvieran más demanda, usando como entradas el evento que se transmitía, el día y pronósticos externos.
- Hacer prefetch antes del corte. Para esos puntos, los anuncios se buscaban y procesaban antes y quedaban en nuestro propio storage, así el corte se servía desde el storage en lugar de una estampida de pedidos en vivo.
- Realimentar el pronóstico. Las estadísticas se alimentaban con lo que pasaba de verdad, así el pronóstico se ajustaba con el tiempo en lugar de quedar como una estimación fija.
Resultado. Para los cortes que marcaba el pronóstico, la parte cara (pedirles a los ad servers y procesar los anuncios) se hacía antes, con un calendario que controlábamos nosotros, y no en el mismo segundo que todos los espectadores del canal. Es la misma idea que AWS MediaTailor documenta para el prefetch, construida en casa y guiada por nuestro propio pronóstico. La lección que me quedo: cuando podés predecir la estampida, no hagas la puerta más rápida; hacé el trabajo antes de que se abra.
Leé el caso completo: prefetch de anuncios guiado por pronóstico para los cortes de Pluto TV →
La conclusión
Un thundering herd no es un problema de carga; es un problema de momento. Las mismas casas, los mismos pedidos, las mismas tareas están bien cuando llegan repartidos en un minuto y son fatales cuando llegan en el mismo segundo. Antes de agregar capacidad, preguntate qué sincronizó a tus clientes (un corte, un vencimiento, un número redondo en un reloj, un corte en un stream en vivo) y elegí la salida: repartirlos, que uno haga el trabajo, dosificarlos o llegar antes.
Referencias
- Schneider et al., Evaluating the Magnitude and Duration of Cold Load Pick-up on Residential Distribution Feeders (IEEE Transactions on Power Systems, 2016).
- GE Vernova, Distribution System Feeder Overcurrent Protection (GET-6450).
- Google SRE book, Distributed Periodic Scheduling with Cron y Addressing Cascading Failures.
- systemd, systemd.timer.
- Firebase, Scale your FCM app.
- Nishtala et al., Scaling Memcache at Facebook (NSDI 2013).
- Vattani, Chierichetti, Lowenstein, Optimal Probabilistic Cache Stampede Prevention (PVLDB, 2015).
- Fastly, Request collapsing; Go, singleflight.
- Linux, epoll_ctl(2); LWN, epoll: add EPOLLEXCLUSIVE flag (2015).
- Slack, incidente del 2017-10-31.
- Marc Brooker, Exponential Backoff And Jitter (AWS Architecture Blog, 2015).
- Metcalfe & Boggs, Ethernet: Distributed Packet Switching for Local Computer Networks (CACM, 1976).
- Kubernetes, Pod lifecycle: container restarts.
- Queue-it, First-in-first-out randomization.
- AWS Elemental MediaTailor, Prefetching ads.