Vector RAG vs Hybrid RAG vs Agentic RAG: una pregunta de beneficios, tres respuestas
La búsqueda por similitud encuentra el documento correcto. Un grafo encuentra los conectados. Solo un workflow enrutado con datos en vivo responde lo que aplica a este empleado. Una comparación de producción con números, modos de falla y un caso real.
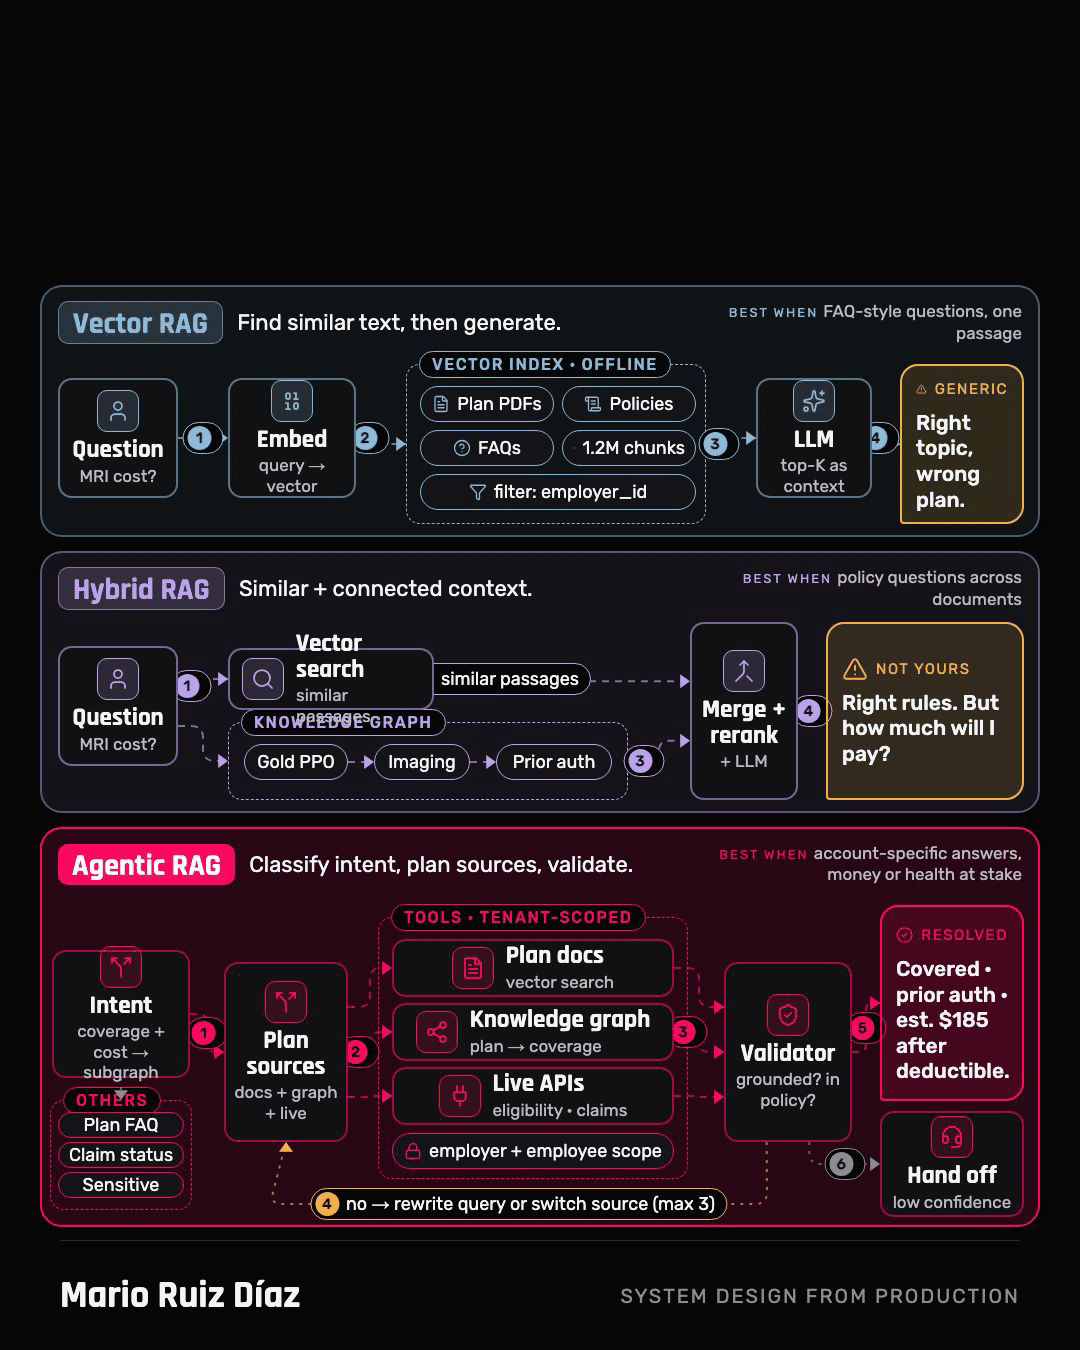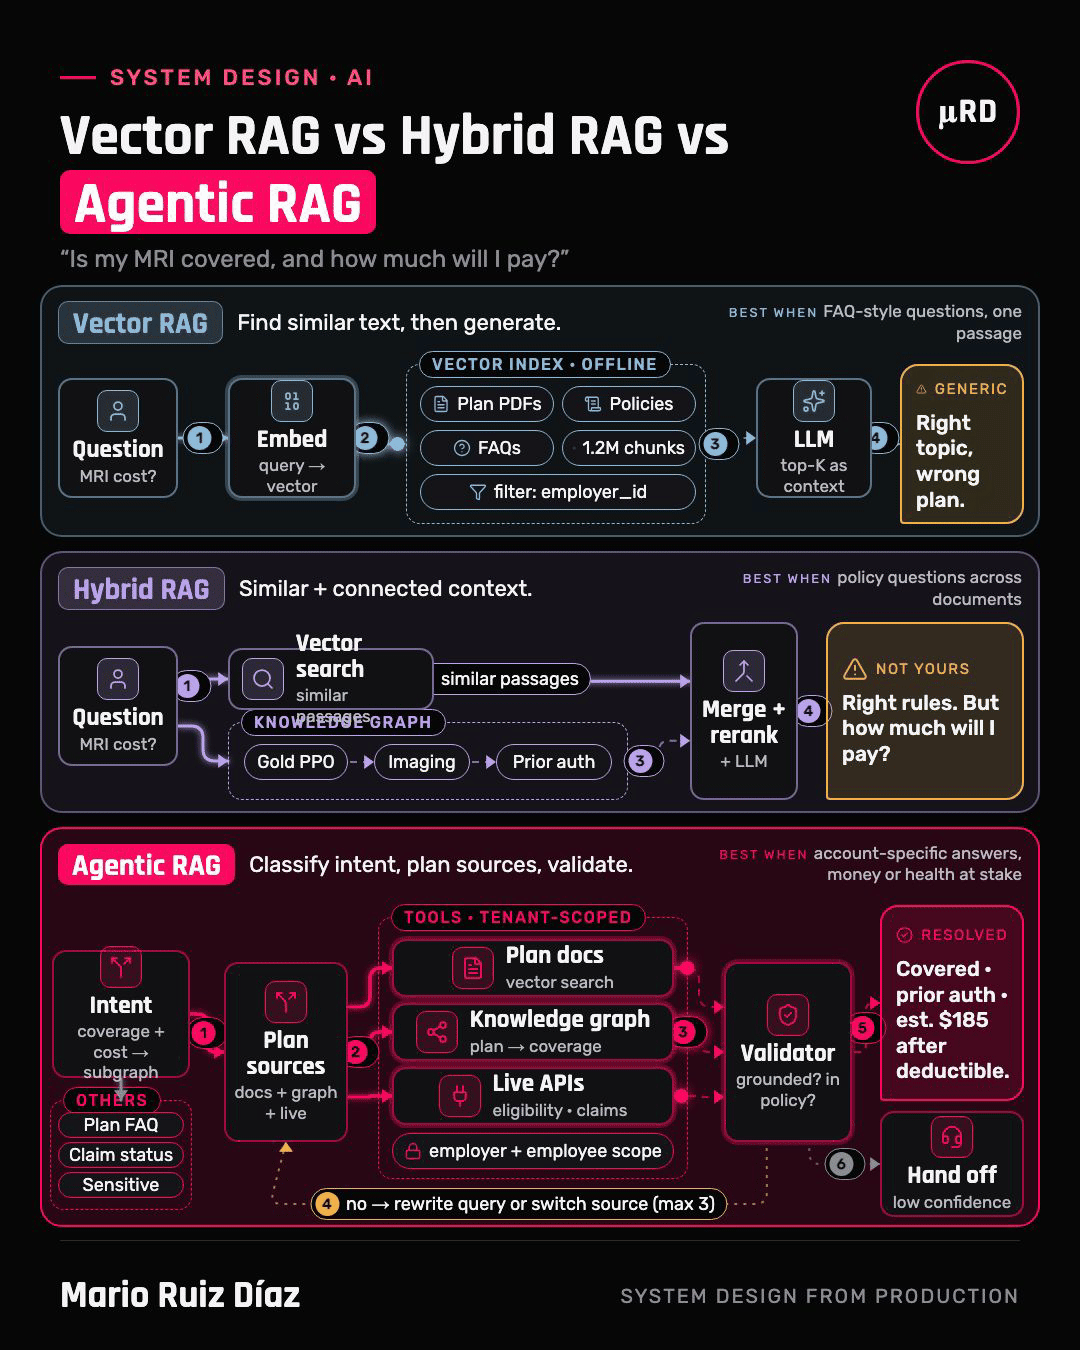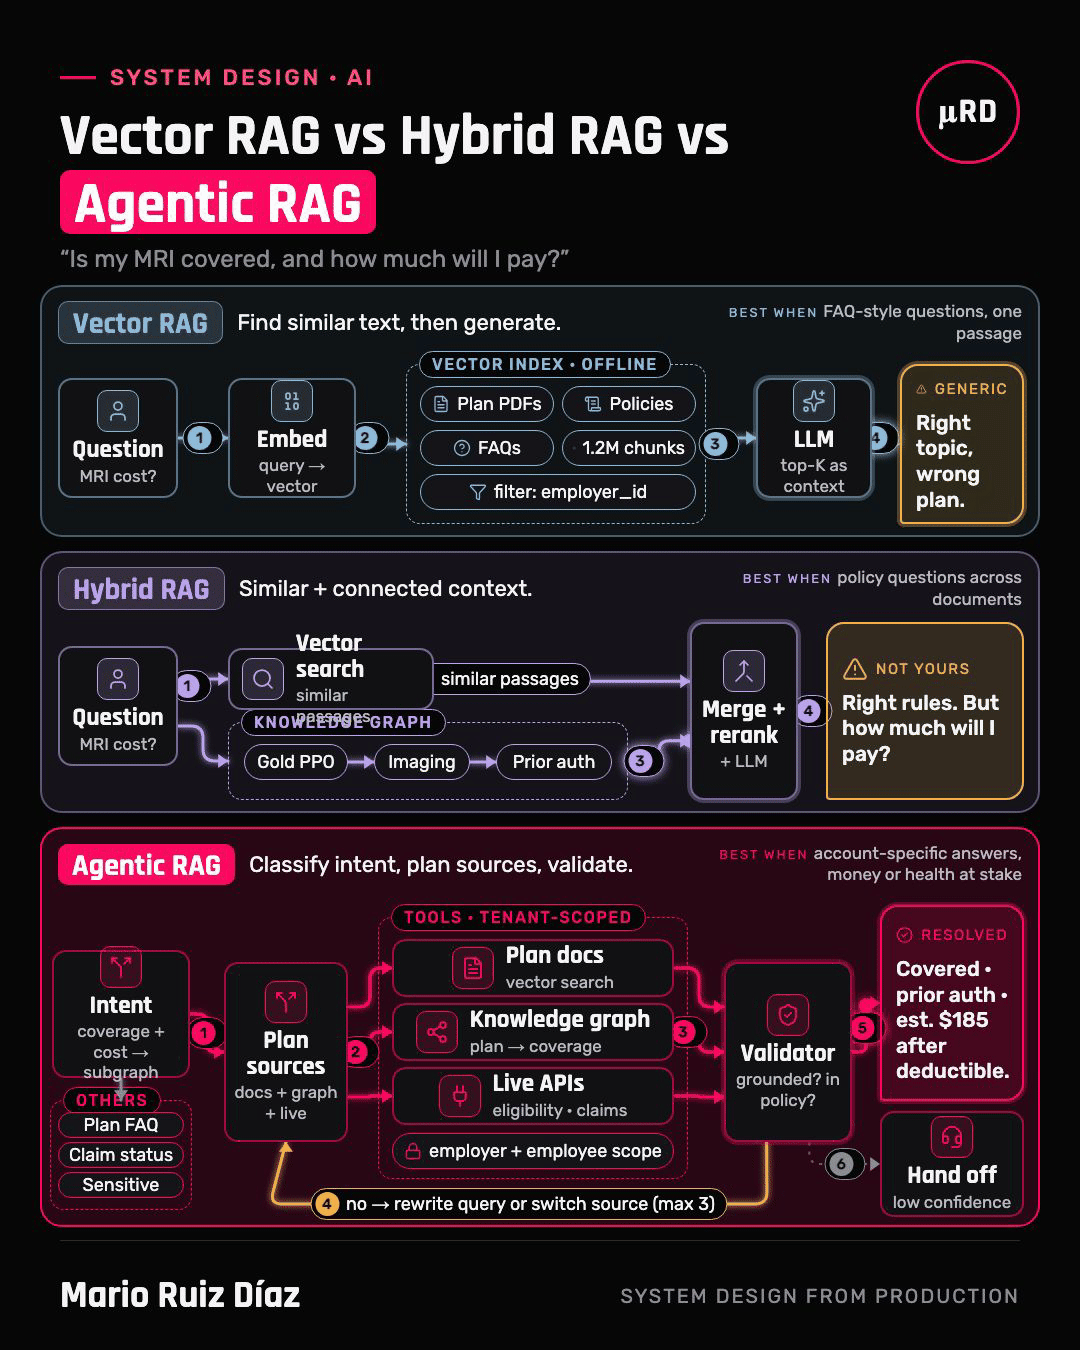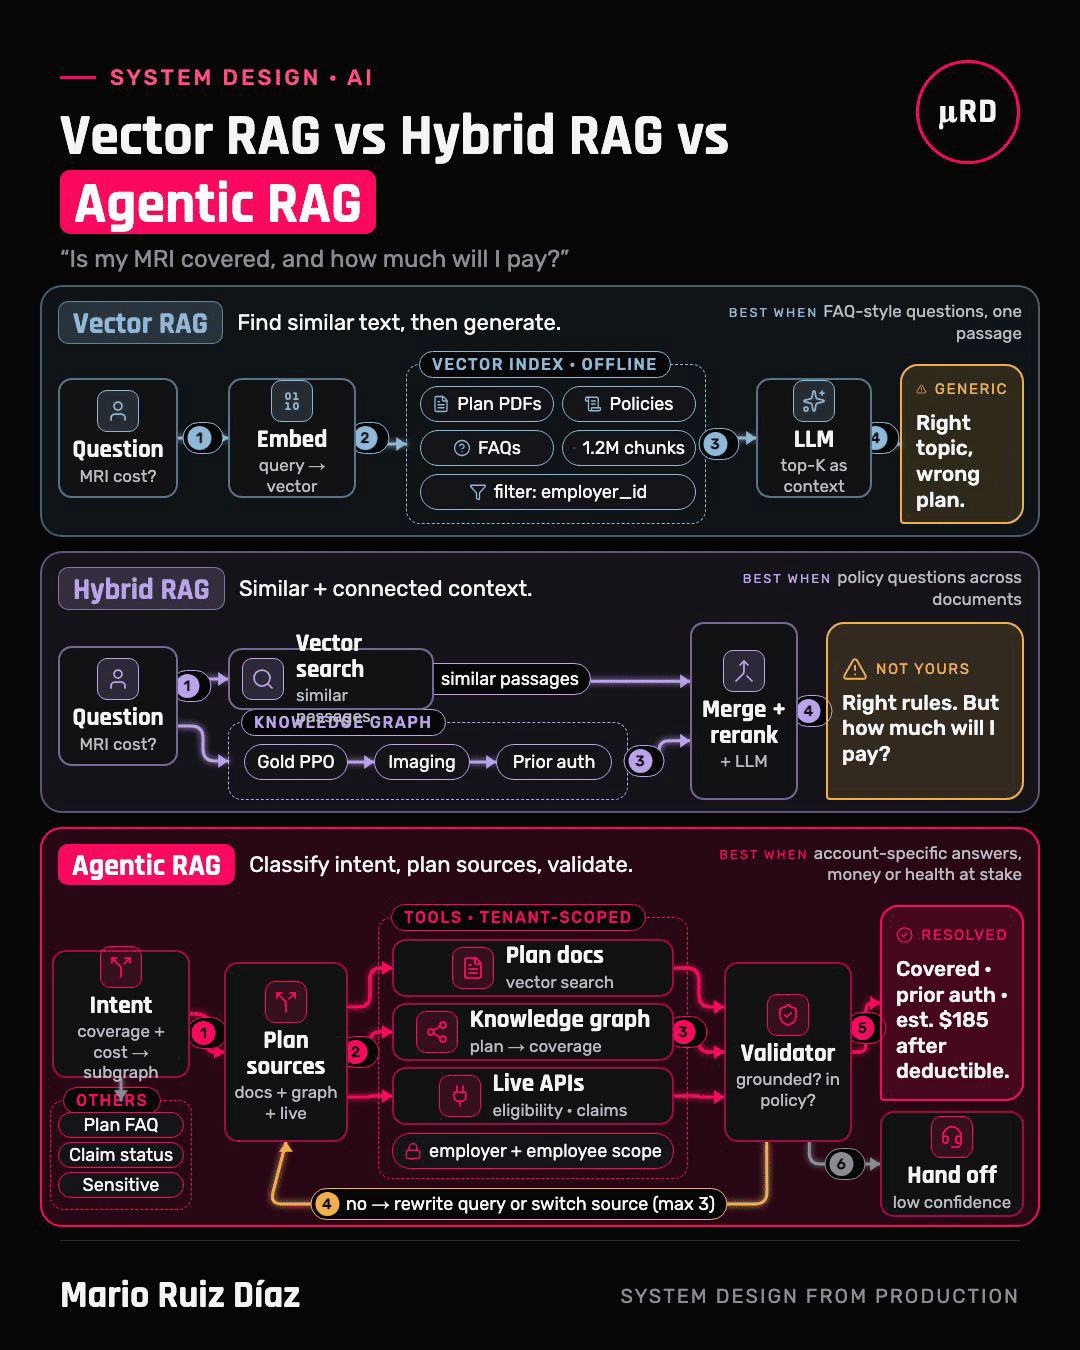
Un empleado escribe: "¿Mi resonancia está cubierta y cuánto voy a pagar?"
Responden tres asistentes.
El primero devuelve un párrafo sobre cobertura de imágenes sacado de un documento de plan. Es correcto, está bien escrito y no sirve: es el tema correcto para la persona equivocada, porque el empleado tiene otro plan.
El segundo encuentra el plan correcto, lo sigue hasta la cobertura de imágenes y la política de autorización previa, y explica bien las reglas. Igual no puede decir cuánto va a pagar este empleado, porque eso depende de cuánto deducible ya consumió este año.
El tercero enruta la pregunta, trae las reglas del plan y la elegibilidad y el deducible del empleado en vivo desde el sistema de registro, verifica la respuesta contra la política y contesta con un número, o pasa la conversación a una persona cuando no está seguro.
A los tres se los llama RAG. Solo uno resuelve la pregunta. Este artículo compara los tres, cuánto cuesta cada uno y dónde se rompe cada uno.
El problema: tres tipos de conocimiento detrás de una pregunta
"Retrieval-augmented generation" suena a una sola técnica. En producción es una decisión sobre de dónde sale cada parte de la respuesta. La pregunta de la resonancia necesita tres tipos de conocimiento:
- Documentos: lo que dice el plan sobre imágenes. Texto no estructurado, cambia pocas veces al año.
- Relaciones: qué cobertura pertenece a qué plan, qué política aplica a qué cobertura, qué FAQ modifica qué cláusula. Estructura que vive entre los documentos.
- Estado personal en vivo: el plan, la elegibilidad y los claims de este empleado. Datos estructurados que cambian todos los días y se gobiernan por empleador.
Un diseño que solo recupera documentos puede responder el primer tipo. La mayoría de las preguntas empresariales mezclan los tres.
Requisitos
- Correcto para esta persona: una respuesta sobre el plan de otro es una respuesta incorrecta, por fluida que sea.
- Aislamiento por tenant: los documentos y datos del empleador A nunca pueden llegar a los empleados del empleador B, con ningún prompt.
- Permisos aplicados en el origen: el asistente no puede ver más de lo que el empleado vería en el portal.
- Auditable: cada respuesta trazable a los pasajes y datos que usó.
- Escalamiento: cuando la confianza es baja o el tema es sensible, toma la conversación una persona con todo el contexto.
- Latencia conversacional: pocos segundos por turno, no decenas.
Estimación de escala
bswift informó más de 750.000 mensajes de Emma en 150.000 sesiones de chat en 2025: unos 5 mensajes por sesión y alrededor de 2.000 mensajes por día en promedio, con el período de inscripción anual concentrando la carga en pocas semanas. Con eso como ancla, y supuestos ilustrativos para el resto:
| Dato | Valor |
|---|---|
| Mensajes por año | 750.000 (informado) |
| Día promedio / día de inscripción anual | ~2.000 / ~10.000 mensajes |
| Llamadas al LLM por mensaje | 3 (enrutar, componer, validar) |
| Tokens por mensaje | ~7.000 (casi todo contexto recuperado) |
| Corpus (ilustrativo) | 1.000 empleadores × 20 documentos de plan × 30 páginas |
Eso da:
- ~5.000 millones de tokens por año, dominados por el contexto, no por la respuesta. La precisión de la recuperación es una palanca de costo: cada fragmento irrelevante se paga tres veces.
- ~1,2 millones de fragmentos (dos por página), que con 1.536 dimensiones son ~7 GB de vectores. El tamaño no es lo difícil; lo difícil es filtrar por tenant en cada consulta.
- ~30.000 llamadas al LLM en un día pico. Pasar cada turno por el modelo más grande es un desperdicio: un modelo chico y rápido puede clasificar la intención, y el caro solo compone.
Enfoque 1: Vector RAG
Deslizá hacia el costado para ver el diagrama completo →
Los documentos se dividen en fragmentos, cada fragmento se convierte en un embedding y los vectores van a un store con metadata (tenant, plan, documento). Al llegar la pregunta, se la embebe, se recuperan los K fragmentos más parecidos, se filtran por tenant y se le pasan al LLM como contexto.
Dónde brilla
- Simple de construir y barato de operar. Un índice, una consulta, una llamada al modelo.
- Excelente para preguntas cuya respuesta vive en un solo pasaje: "¿qué es un evento de vida calificado?"
- Fácil de actualizar: se re-embebe un documento cuando cambia.
Dónde se rompe
- Similitud no es relevancia. Los fragmentos de "cobertura de imágenes" de cinco planes se parecen; el recuperador no puede saber cuál es el plan de este empleado.
- Las relaciones son invisibles. La respuesta muchas veces necesita la cobertura y la política a la que apunta y la excepción de una FAQ. El top-K rara vez trae las tres.
- El estado personal queda fuera de alcance. Los deducibles y los claims no son documentos. Copiarlos al vector store crea una segunda copia, desactualizada y sin gobierno, de datos sensibles.
- El filtro por tenant es un punto único de falla. Falta un filtro de metadata y aparece en el contexto el plan de otro empleador.
Enfoque 2: Hybrid RAG (vectores + grafo de conocimiento)
Deslizá hacia el costado para ver el diagrama completo →
La búsqueda por similitud sigue encontrando los pasajes de entrada, y un grafo de conocimiento suma lo que está conectado a ellos: plan → cobertura → política → FAQ. Las entidades de la pregunta (nombre del plan, tipo de cobertura) se buscan en el grafo, se trae su vecindario y los dos conjuntos de resultados se combinan y se reordenan antes de que responda el LLM. Muchos equipos suman también búsqueda por palabras clave (BM25) para términos exactos como códigos de plan.
Dónde brilla
- Contexto correcto, no solo parecido. La respuesta sobre imágenes viene con la política de autorización previa que la gobierna.
- Recuperación explicable. Un camino en el grafo es una justificación legible: este plan, esta cobertura, esta política.
- Mejor recall en preguntas que cruzan documentos, sin inflar el tamaño de los fragmentos.
Dónde se rompe
- El grafo es un producto que hay que mantener. Extracción de entidades, esquema y actualizaciones son ingeniería real, y un edge desactualizado es peor que ninguno.
- Sigue sin estado personal. La respuesta es correcta para el plan, no para la persona: no puede decir cuánto va a pagar este empleado.
- Más latencia y más piezas: dos sistemas de recuperación, un paso de combinación y un reranker en cada turno.
Enfoque 3: Agentic RAG
Deslizá hacia el costado para ver el diagrama completo →
El modelo ya no recibe un contexto fijo. Un router clasifica cada turno y planifica qué fuentes necesita, casi siempre más de una: documentos, el grafo y datos de negocio en vivo traídos del sistema de registro mediante APIs acotadas al empleador y a los permisos del empleado. Las fuentes elegidas se consultan en paralelo, sus resultados se unen en un solo contexto que registra de dónde salió cada dato, un paso de composición escribe la respuesta y un paso de validación verifica grounding, política y confianza antes de responder o derivar a una persona.
La pregunta de la resonancia es el caso típico: necesita las tres a la vez. Los documentos del plan dicen que las imágenes están cubiertas, el grafo vincula esa cobertura con la política de autorización previa y la API en vivo dice cuánto deducible queda. Los turnos con varias fuentes traen dos problemas que el RAG de una sola fuente nunca tiene:
- Resultados parciales. Una fuente no responde a tiempo o falla. La respuesta aclara lo que no pudo confirmar ("cobertura confirmada, estimación de costo no disponible en este momento") o pasa a una persona; nunca rellena el hueco.
- Conflictos. Los documentos dicen una cosa y el registro en vivo otra. La precedencia es una decisión de diseño, no del modelo: el dato en vivo sobre el documento, el plan del empleado sobre el texto genérico, la regla más específica sobre la general.
Hay dos formas de construirlo, y la diferencia importa más que el nombre:
Deslizá hacia el costado para ver el diagrama completo →
- Un loop de agente libre le da al modelo todas las herramientas y lo deja decidir el próximo paso en cada turno hasta que elige parar. Flexible, y difícil de acotar: costo, latencia y caminos varían en cada conversación.
- Un workflow explícito (un state graph, como LangGraph) fija los nodos y los edges. El modelo sigue clasificando y componiendo, pero hacia dónde puede ir la conversación está diseñado, es observable y se puede testear. Para preguntas de salud y dinero, es la versión que sobrevive una revisión.
Dónde brilla
- Respuestas para esta persona. La elegibilidad y los claims en vivo hacen que la respuesta sea específica y actual.
- Una sola fuente de verdad. Los datos personales quedan en el sistema que los gobierna; los permisos se aplican ahí, no se reimplementan en la capa de IA.
- Resolución, no contención. Validación más derivación explícita significan que el asistente para cuando corresponde, con contexto, en lugar de adivinar.
Dónde se rompe
- El enrutamiento pasa a ser el camino crítico. Una ruta equivocada manda una pregunta de claims a los documentos y devuelve una respuesta segura e irrelevante.
- La latencia y el costo se suman. Tres o más llamadas al modelo más llamadas a APIs por turno; sin un modelo chico para enrutar y recuperación en paralelo, los turnos se vuelven lentos.
- Testear es más difícil. Cada camino necesita cobertura; sin un set de regresión, un cambio de prompt rompe una ruta en silencio.
Lado a lado
| Vector RAG | Hybrid RAG | Agentic RAG (workflow) | |
|---|---|---|---|
| Responde | Lo que dicen los documentos | Lo que dicen los documentos, conectado | Lo que aplica a esta persona, ahora |
| Fuentes | Vector store | Vectores + grafo (+ keywords) | Vectores, grafo y APIs en vivo, varias por turno |
| Datos personales | No (o una copia vieja) | No | Sí, del sistema de registro |
| Llamadas al modelo por turno | 1 | 1-2 | 3+ |
| Riesgo principal | Contexto parecido pero incorrecto | Deriva del grafo | Ruta equivocada, caminos sin testear |
| Ideal para | Preguntas tipo FAQ de un solo pasaje | Preguntas de políticas que cruzan documentos | Preguntas de la cuenta con consecuencias |
Son capas, no rivales. Los asistentes en producción suelen tener los tres: búsqueda vectorial dentro de la recuperación con grafo, y ambas dentro de un workflow enrutado que además consulta datos en vivo.
Modos de falla en producción
- Fuga entre tenants. Un filtro faltante en un camino de recuperación mezcla empleadores. Aplicá el tenancy en la capa de herramientas y en los stores, y probalo con consultas adversariales, no solo con tests unitarios.
- Embeddings desactualizados. Los planes cambian en la renovación y los fragmentos viejos siguen respondiendo. Versioná los documentos y re-indexá ante cada cambio, con la fecha de vigencia en la metadata.
- Datos personales alucinados. Si los datos en vivo no están disponibles, el modelo llena el hueco con algo plausible. Hacé de "dato no disponible" un estado explícito que deriva.
- Enrutamiento equivocado. Medí la precisión del router como métrica y revisá cada semana las conversaciones mal enrutadas.
- Escalar de más o de menos. Si escala de más, el asistente es un menú telefónico; si escala de menos, adivina sobre dinero. Ajustá los umbrales contra resultados reales, no contra la intuición.
- Prompt injection a través de documentos. El texto recuperado es entrada no confiable. Mantené las instrucciones fuera del canal de contexto y validá las salidas contra la política.
- Contexto parcial con varias fuentes. Falla una de varias fuentes y la respuesta se compone con el resto como si estuviera completa. Registrá qué fuentes necesitaba cada respuesta y cuáles devolvieron datos.
- Conflictos entre fuentes. Los documentos y los datos en vivo no coinciden. Codificá la precedencia de forma explícita y registrá cada conflicto; muchas veces son bugs de calidad de datos aguas arriba.
- Regresiones silenciosas. Cada cambio de prompt, modelo o recuperación corre contra un set dorado de preguntas reales antes de salir.
Elegir un stack
| Capa | Opciones comunes | Nota |
|---|---|---|
| Búsqueda vectorial | pgvector, OpenSearch, Pinecone, Weaviate | Elegí la que filtre por tenant de forma eficiente a tu escala |
| Grafo de conocimiento | Neo4j, Amazon Neptune | Vale la pena cuando las respuestas cruzan documentos relacionados |
| Orquestación | LangGraph, workflows de LlamaIndex, máquinas de estado propias | Preferí grafos explícitos en dominios regulados |
| Evaluación y tracing | LangSmith, Ragas, Arize Phoenix | El set dorado de preguntas importa más que la herramienta |
| Modelos | OpenAI, Anthropic, modelos abiertos vía una capa agnóstica | Modelo chico para enrutar, más grande para componer |
Caso real: Emma en bswift
Situación. bswift administra beneficios para grandes empleadores: miles de empleados por cliente, cada uno con sus planes, su elegibilidad y sus claims. El soporte pasaba por formularios, teléfono y email. Las respuestas vivían repartidas entre documentos de planes, stores relacionales y no relacionales, y reglas de negocio en tiempo real en la plataforma .NET de bswift, todo bajo tenancy y gobierno por empleador.
Tarea. Construir un asistente que resuelva las consultas de beneficios de cada empleado en particular, no uno que las desvíe con textos genéricos de FAQ, sin sacar datos sensibles de la plataforma que los gobierna.
Acción.
- Diseñé la arquitectura de punta a punta como Principal Engineer: una interfaz conversacional en Next.js, servicios en AWS, una capa de modelos agnóstica sobre OpenAI y Anthropic, y un workflow explícito en LangGraph en lugar de un agente libre.
- Un nodo router de entrada clasifica cada turno y elige los caminos de recuperación que necesita: documentos de planes en un vector store, un grafo de conocimiento en Neo4j que vincula planes, coberturas, políticas y documentos, y reglas de negocio en vivo (elegibilidad, claims, inscripción) traídas en tiempo real del backend .NET.
- Los datos en vivo nunca se copian a stores de IA, y cada llamada a herramientas queda acotada al empleador y a los permisos del empleado, aplicados por la plataforma dueña de los datos.
- La derivación se dispara con baja confianza, temas sensibles o cuando el empleado pide una persona, y pasa un resumen de la conversación más el contexto recuperado para que nadie repita nada.
- La calidad se mide, no se supone: tracing con LangSmith, un set de regresión con preguntas doradas y revisión humana antes y después de cada cambio.
Resultado. bswift lanzó públicamente la nueva Emma Chat en febrero de 2026 e informa una tasa de resolución autónoma del 80%, con más de 750.000 mensajes en 150.000 sesiones de chat en 2025. Las respuestas son específicas del plan y están basadas en los datos de claims, y las transferencias a representantes humanos conservan todo el contexto.
La lección que me quedo: decidí de dónde sale cada parte de la respuesta antes de elegir una técnica de recuperación. Documentos, relaciones y estado personal en vivo necesitan maquinaria distinta, y el router que elige entre ellas es el componente más importante del sistema.
Leé el caso completo: cómo se diseñó Emma para resolver, no para contener →
Por dónde empezar
- Clasificá tus preguntas reales según lo que necesitan: documentos, relaciones, estado personal. Contalas; la mezcla decide la arquitectura.
- Empezá con vector RAG para la parte que es solo documentos, con los filtros por tenant aplicados y testeados.
- Sumá el grafo solo cuando las preguntas que cruzan documentos fallen de forma medible.
- Traé los datos personales por APIs, nunca copias, acotados a los permisos del usuario.
- Hacé explícito el workflow: router, caminos de recuperación, composición, validación, derivación.
- Armá el set dorado temprano y corrélo en cada cambio.
- Medí resolución, no conversaciones atendidas.
La conclusión
Vector RAG encuentra el documento correcto. Hybrid RAG encuentra los documentos conectados correctos. Un workflow agéntico con datos en vivo responde para la persona real, y sabe cuándo parar. El salto no es un modelo más inteligente; es decidir, de forma explícita, qué fuente es dueña de cada parte de la respuesta.
Referencias
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020).
- Edge et al., From Local to Global: A Graph RAG Approach to Query-Focused Summarization (2024).
- Documentación de LangGraph.
- bswift, anuncio de la nueva Emma Chat AI-native (2026).